애플 FastFrames, 36ms로 반응하는 인터랙티브 비디오 모델
애플이 공개한 FastFrames는 1.3B 모델로 프레임당 36ms, 14B 모델로 45ms에 480p 영상을 만드는 자기회귀 비디오 확산 모델이다. VAE 디코딩과 KV 캐시 갱신을 경량 모듈로 바꾼 원리와 직접 실행법을 정리했다.
Q. 키보드를 누르자마자 영상이 바뀌는, 실시간으로 조종하는 비디오 모델이 있나요? 네. 애플이 11월 17일 공개한 FastFrames는 클립을 한 번에 뽑는 게 아니라 프레임을 한 장씩 만들며 키보드·카메라 입력에 바로 반응하는 자기회귀 비디오 확산 모델입니다. 1.3B 모델이 프레임당 36ms, 14B 모델이 45ms로 480p 영상을 만듭니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 22일 기준이다. 지연 시간·VBench 점수·학습 방식은 논문(arXiv:2611.23226)과 애플 Hugging Face 모델 카드를 직접 열어 확인했다. 라이선스는 모델 카드 안내를 인용했다. 수치는 B200 GPU 기준 논문 측정값이다.
30초 요약
- 무엇인가: 애플이 공개한 자기회귀 2스텝 비디오 확산 모델이다. S 1.3B와 L 14B, 둘 다 Wan2.1 기반, 480p(832×480) 출력이다.
- 속도: S는 GPU 1개에서 프레임당 36ms(초당 28응답), L은 GPU 8개에서 45ms(초당 22응답)다. 사람이 지연을 느끼기 시작하는 50ms 기준을 둘 다 통과한다.
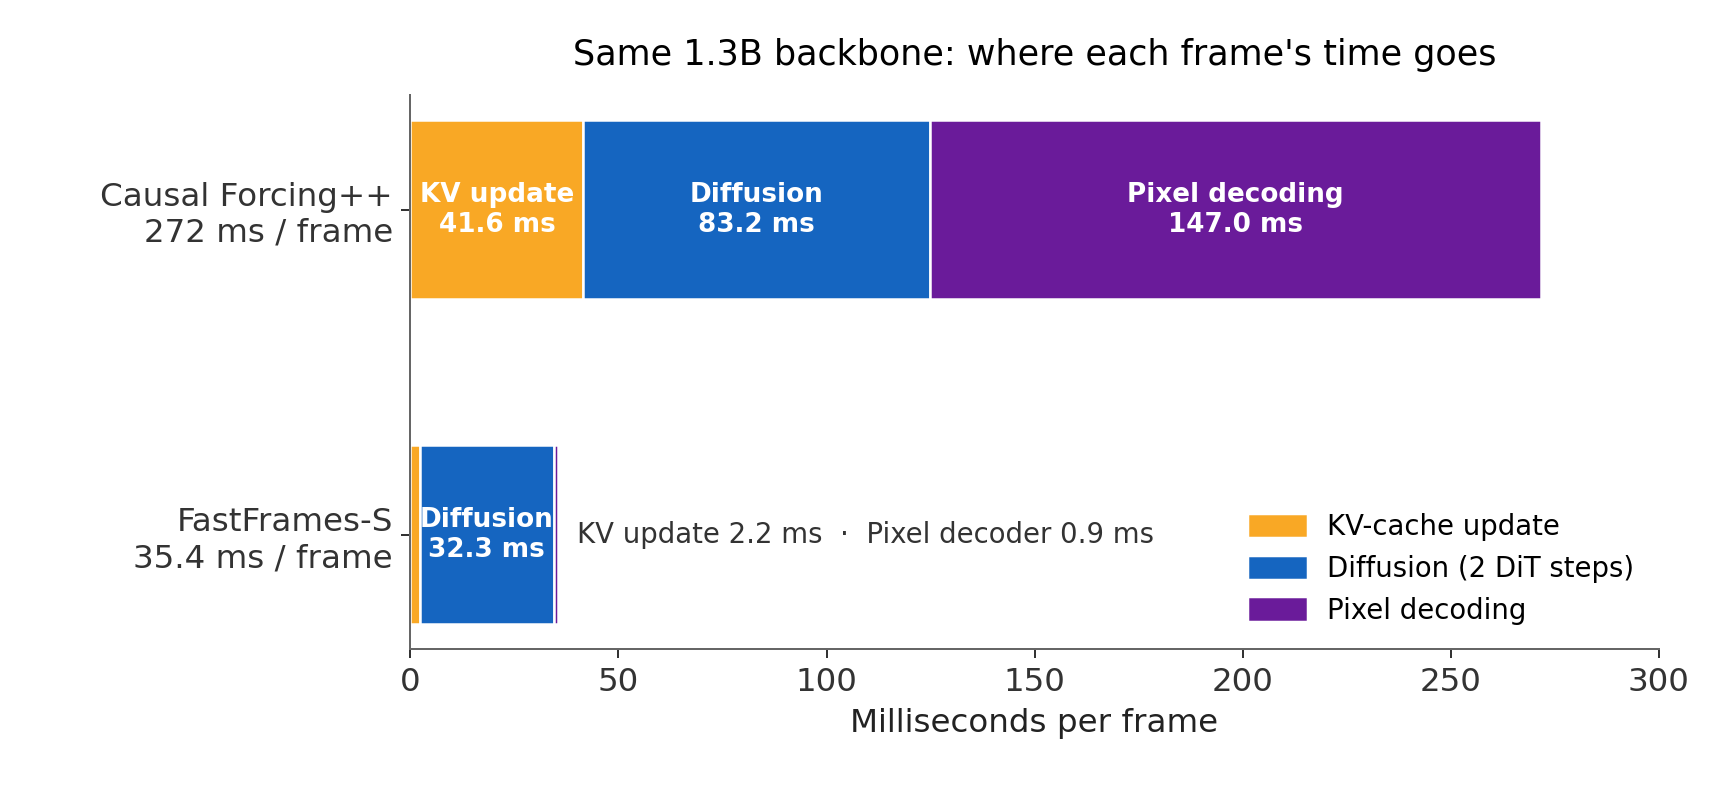
- 핵심 아이디어: 느린 원인은 디노이징이 아니었다. VAE 디코딩(147ms)과 KV 갱신(41.6ms)이 전체 272ms의 70%를 차지했고, 둘을 경량 모듈로 바꿨다.
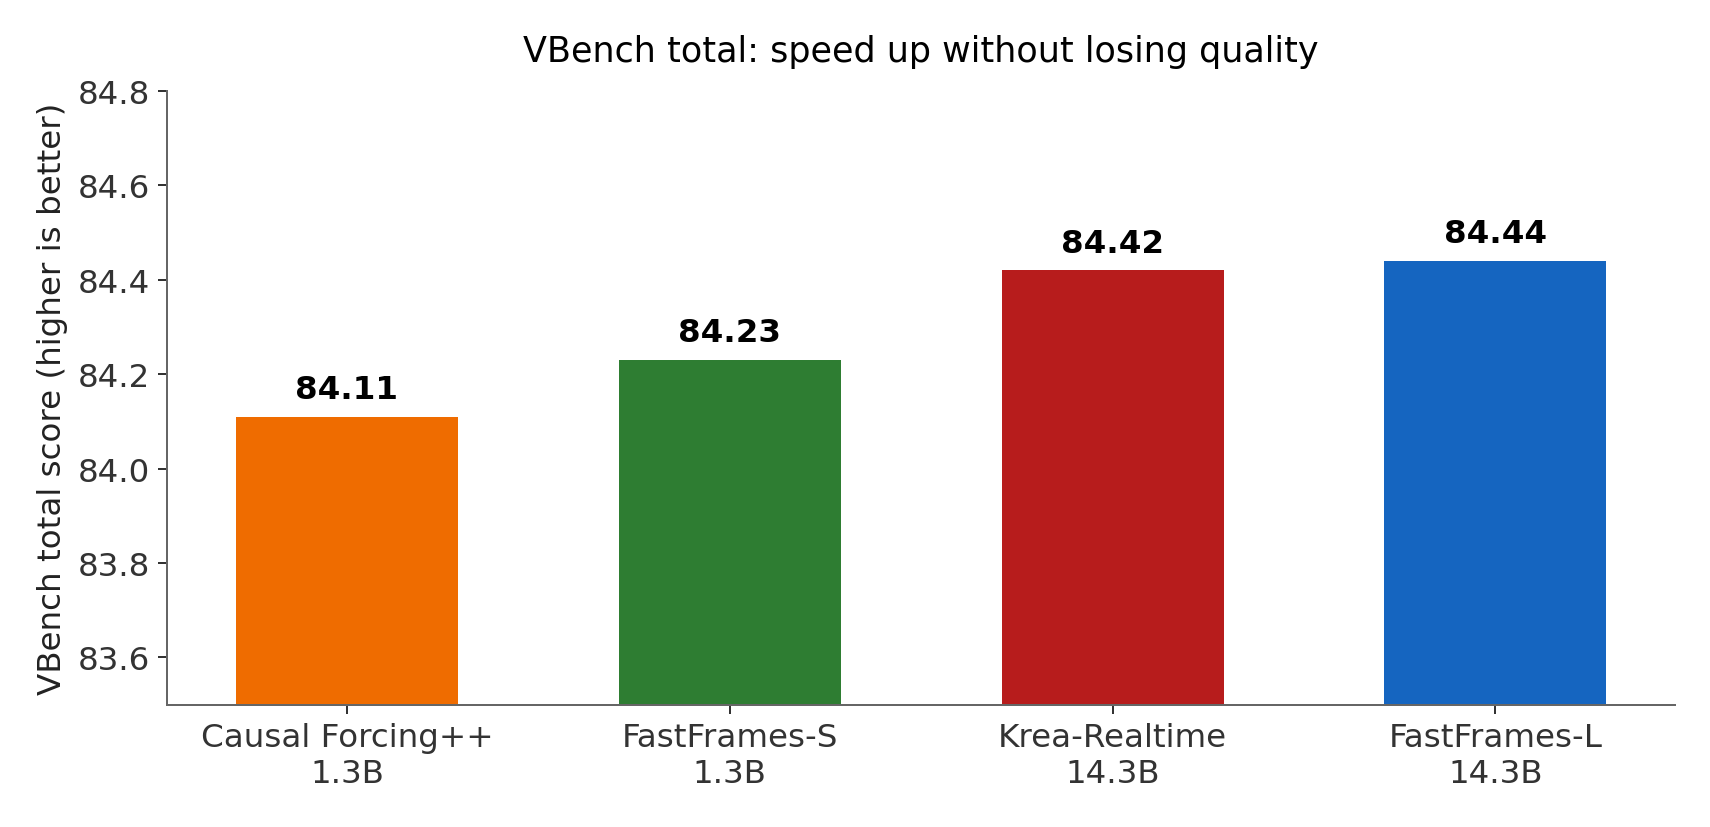
- 품질: VBench 총점은 S 84.23(기준 84.11), L 84.44(기준 84.42)로, 7.6배·10배 이상 빨라지면서도 품질은 동등 이상이다.
- 실행 조건: Linux x86-64, NVIDIA GPU, CUDA 12.8, uv가 필요하다.
FastFrames란 무엇인가 — 클립이 아니라 프레임을 만든다
FastFrames는 영상을 한 번에 만드는 게 아니라, 이전 프레임을 보고 다음 프레임을 한 장씩 이어 만드는 자기회귀 비디오 확산 모델이다.
일반 모델은 클립을 한 번에 만들지만, FastFrames는 스텝마다 잠재 프레임 1장을 만들고 그 사이 새 입력을 받는다. 키보드를 누르면 다음 프레임부터 화면이 바로 반응한다.
가중치는 11월 16일 Hugging Face에, 논문은 11월 17일 arXiv에, 코드는 GitHub에 나왔다. S는 Causal Forcing++에서, L은 Wan2.1-14B 증류에서 왔다. 출력은 832×480, 81프레임, 16fps(약 5초)다.
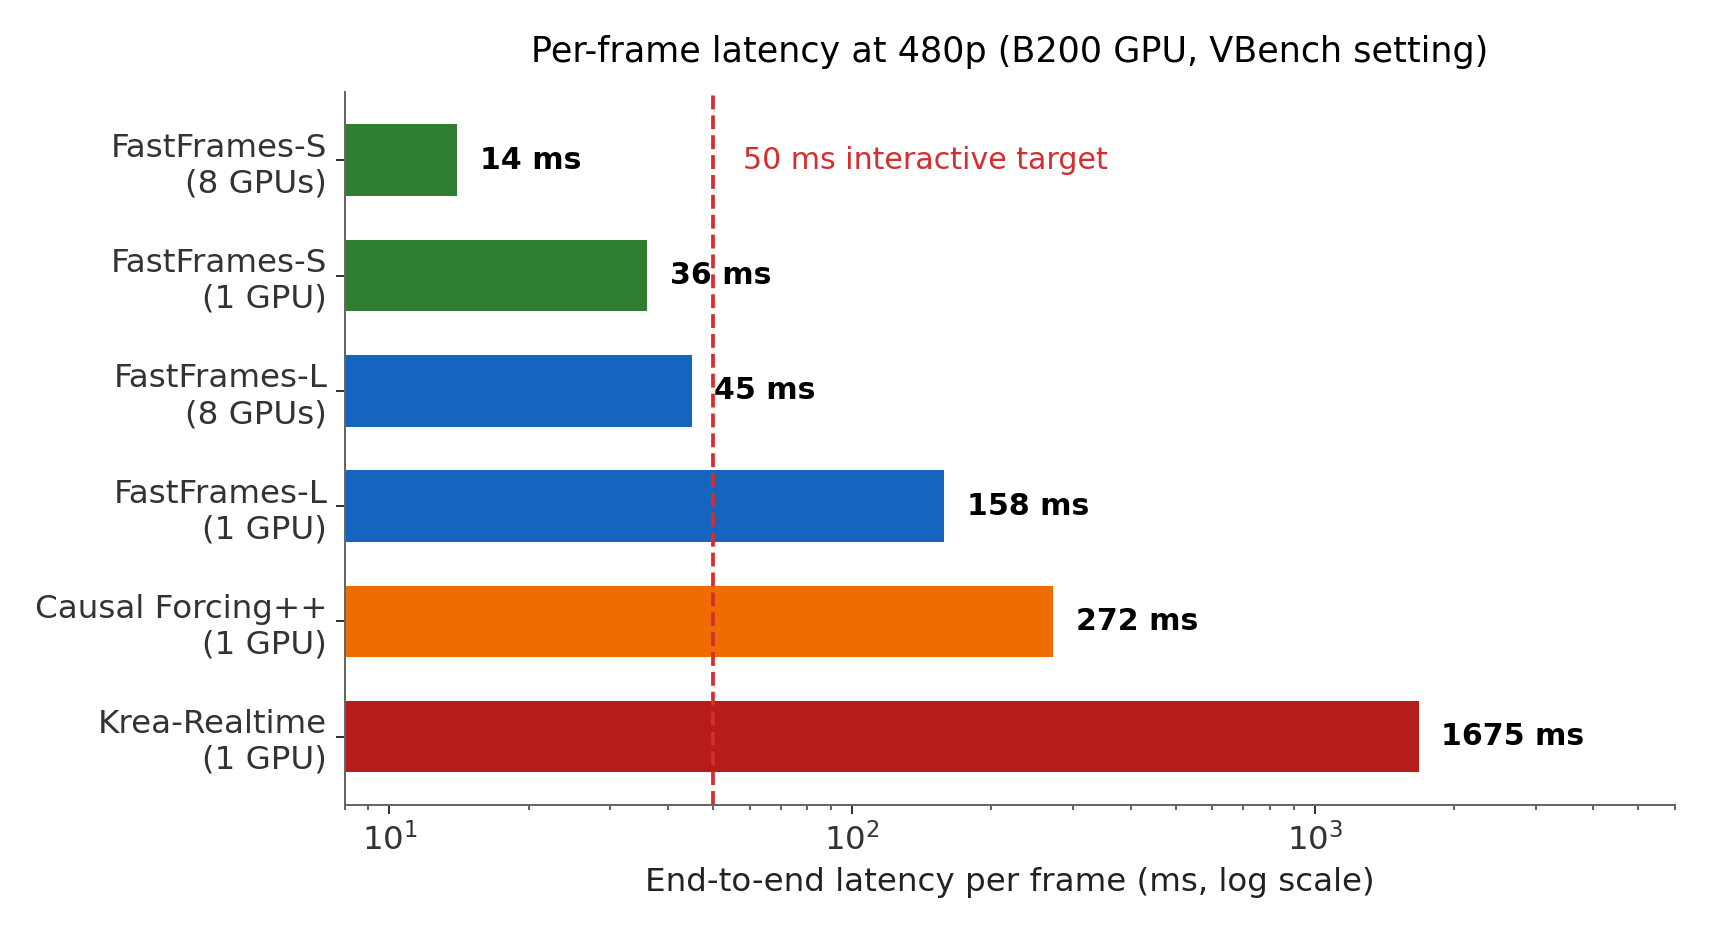
논문은 FPS가 아니라 초당 응답(RPS)을 쓴다. 30FPS로 뽑아도 첫 반응까지 1초가 걸리면 인터랙티브가 아니기 때문이다. 50ms 목표는 곧 20 RPS, S는 27.8, L은 22.2 RPS다. 가장 빠른 기존 모델은 3.68 RPS였다.
병목은 디노이징이 아니었다 — 272ms의 내역
Causal Forcing++은 전체 272ms 중 디노이징이 30%에 불과했고, VAE 디코딩 147ms와 KV 갱신 41.6ms가 절반 이상이었다.
스텝을 2개에서 1개로 줄이면 품질이 크게 떨어지는데 지연 시간은 15%밖에 줄지 않는다. 내역은 DiT 평가 41.6ms, KV 갱신 41.6ms, 디노이징 83.2ms, VAE 디코딩 147ms, 합계 271.8ms다. VAE 디코딩 하나가 DiT 1회 평가의 3.5배다.
36ms를 만드는 세 가지 교체 — 디코더·캐시·시스템
FastFrames는 디노이징 스텝 대신, 시간을 잡아먹던 주변 부품부터 갈아끼웠다.
첫째, 픽셀 디코더다. 범용 VAE 디코더를 ConvNeXt 기반 경량 헤드와 선형 레이어로 바꿨다. DiT의 저해상도 특징에서 바로 RGB 패치를 뽑아 디코딩 지연이 논문 기준 147배 줄었다. 픽셀 공간 종단 학습으로 품질도 유지했다.
둘째, KV 정제 네트워크다. 노이즈 섞인 캐시를 고치려고 DiT를 한 번 더 돌리던 과정을 작은 보정 네트워크로 바꿨다. 2.2ms로 10배 빨라졌다.
셋째, 시스템 최적화다. 지속 KV 버퍼, RoPE·조건 사전 계산, QKV 융합, CUDA 그래프로 DiT 1회 평가가 41.6ms에서 16.4ms로 줄었다. 합계는 DiT 16.1+16.2ms, KV 정제 2.2ms, 픽셀 디코더 0.9ms로 35.4ms다.
속도 대 품질, VBench로 확인 — 빨라졌는데 점수는 그대로
같은 VBench 설정에서 총점은 S 84.23(기준 84.11), L 84.44(Krea-Realtime 84.42)로 동등 이상이다.
| 모델 | 크기 | 지연 | 총점 | 품질 |
|---|---|---|---|---|
| Causal Forcing++ | 1.3B | 272ms | 84.11 | 85.09 |
| FastFrames-S | 1.3B | 36ms | 84.23 | 85.30 |
| Krea-Realtime | 14.3B | 1,675ms | 84.42 | 85.08 |
| FastFrames-L | 14.3B | 45ms(8 GPU) | 84.44 | 85.48 |
S는 같은 1.3B 백본·같은 DiT 가중치로 7.6배 빨라졌고 총점·품질은 오히려 올랐다. 의미 점수만 소폭 내렸다. L은 단일 GPU 158ms, 8 GPU 45ms로 Krea-Realtime(1,675ms)보다 10배 이상 빠르면서 총점은 같다. 8 GPU에서 S는 14ms까지 내려간다. 모두 B200 GPU, 약 480p, 동일 VBench 설정의 논문 측정값이다.
키보드로 조종하는 영상 — LingBot·RealWonder가 16~22배 빨라졌다
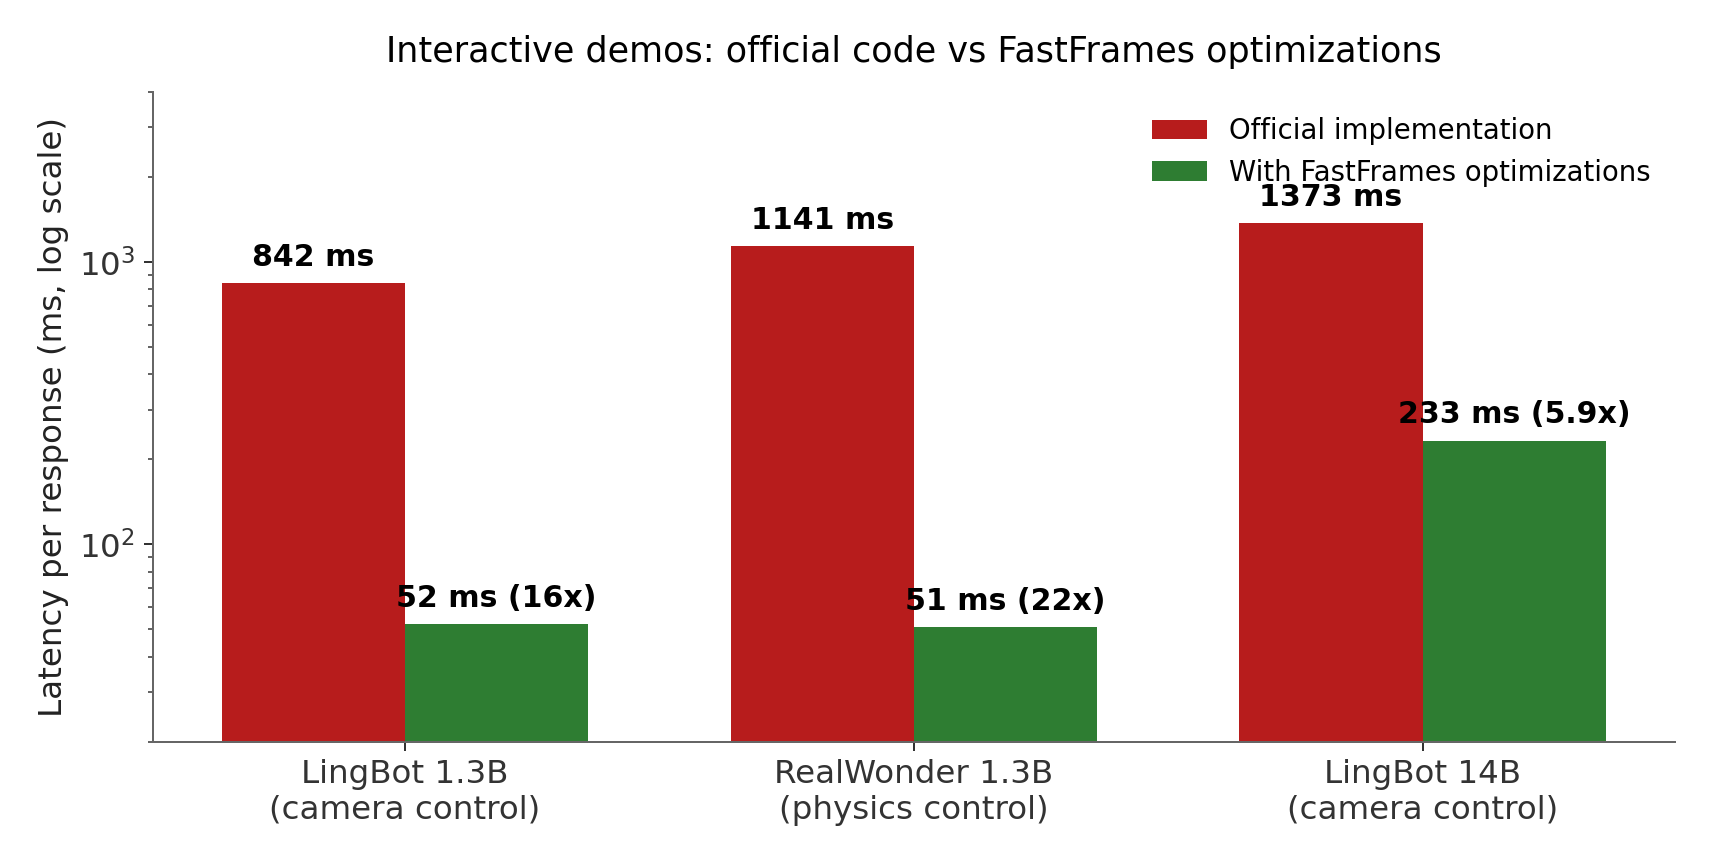
FastFrames의 최적화는 자기 모델에만 묶이지 않는다. LingBot과 RealWonder에도 적용돼 응답 시간이 16배·22배 줄었다.
LingBot 1.3B는 842ms(2 GPU)에서 52ms(8 GPU)로 16배, RealWonder 1.3B는 1,141ms에서 51ms로 22배, LingBot 14B는 1,373ms에서 233ms로 5.9배 줄었다. 두 모델 모두 50ms대 응답에 근접했다.
데모도 공개됐다. LingBot 데모를 실행하면 http://localhost:8000에서 키보드·마우스로 6-DoF 카메라 비행을 하며 영상을 실시간으로 조종할 수 있다. 로컬 영상 모델의 다른 접근은 FreeVideo 로컬 추론 정리에서 볼 수 있다.
내 PC에서 직접 돌리는 법 — Linux·NVIDIA GPU·uv가 필요하다
실행 환경은 Linux x86-64, NVIDIA GPU, CUDA 12.8, uv다. 맥·윈도우 네이티브 실행은 공식 문서에 없다.
git clone https://github.com/apple-aiml-research/ml-fastframes
cd ml-fastframes
uv sync
uv run python scripts/generate.py --model ff-s --checkpoint-dir checkpoints \
    --prompt "A corgi surfing a wave at sunset" --seed 0 --output outputs/corgi.mp4
체크포인트는 저장소 docs 가이드를 따라 받는다. L은 --model ff-l, 지연 시간은 evaluation/latency/benchmark.py로 재현한다. LingBot 데모는 apps/lingbot/demo.py --gpus 1로 실행한다.
미리 알아둘 것 두 가지. 첫째, 라이선스: 코드는 Apple Sample Code License, 가중치는 연구용 라이선스라 상용 이용이 제한된다. 둘째, 하드웨어: 36ms·45ms는 B200 기준이라 소비자용 GPU 속도는 논문에 없다. 로컬 AI 하드웨어는 RTX Spark 데스크톱 정리도 참고할 만하다.
토리스의 판단
FastFrames의 교훈은 "모델을 더 작게"가 아니라 "주변을 먼저 보라"는 것이다. 디노이징은 이미 2스텝까지 줄여 둔 상태였고, 남은 시간 대부분은 VAE 디코딩과 KV 갱신에 있었다. 이걸 갈아끼우자 1.3B 모델이 7.6배 빨라졌다.
다만 연구 릴리스다. 480p·5초·B200급 GPU·연구용 라이선스라는 한계가 분명하다. 쓸 곳은 상용 영상 제작이 아니라 인터랙티브 월드 모델·게임·로봇 시뮬레이션 연구의 출발점이다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾