Baseten bison-1·groundhog-1 결정 모델 1위 정리
Baseten이 11월 20일 공개한 bison-1은 Artificial Analysis Decision Index v2.1에서 76점으로 19개 결정 모델 중 1위다. Gemma 4 기반 형제 모델 groundhog-1과 함께 128k 컨텍스트·가격·API 사용법을 정리했다.
Q. LLM에 글을 쓰게 하는 게 아니라, "이건 환불 건인가요?" 같은 판단을 확률로 답하게 할 수는 없나요? 네. Baseten이 2026년 11월 20일 공개한 bison-1·groundhog-1은 글을 만들지 않고 각 선택지의 보정된 확률을 돌려주는 결정 모델(decision model) 입니다. bison-1은 Artificial Analysis Decision Index v2.1에서 76점, 19개 모델 중 1위를 기록했고, 두 모델 모두 128k 토큰 컨텍스트를 지원합니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 22일 기준이다. 점수·가격·컨텍스트·파라미터는 Baseten 공식 블로그(2026년 11월 20일)와 Hugging Face 모델 카드(
baselabs/bison-1,baselabs/groundhog-1)를 직접 열어 확인했다. LongMemEval은 Baseten 자체 측정값이고, groundhog-1의 Decision Index 점수와 응답 지연(ms)은 공개 수치가 없어 확인하지 못했다.
30초 요약
- 무엇인가: Baseten의 새 결정 모델 2종. bison-1은 31B dense, groundhog-1은 26B MoE(약 4B active), 둘 다 Google Gemma 4 파인튜닝이다.
- 성적: bison-1은 Artificial Analysis Decision Index v2.1에서 76점, 19개 중 1위. 2위 d1.2-ultra(75점), 기존 mammoth-1(71점)을 앞섰다.
- 정확한 확률: Brier 점수 0.14로 인덱스 내 최저. "83% 확신"이면 실제로 그만큼 맞을 확률이 높다는 뜻이다.
- 컨텍스트: 131,072 토큰(128k)으로 이전 세대 16k의 8배. 정책 문서나 긴 대화 기록을 통째로 넣고 판단할 수 있다.
- 가격: bison-1은 100만 토큰당 $0.10, groundhog-1은 $0.035. 가중치는 Hugging Face에 공개돼 있다.
결정 모델이란 — 텍스트 대신 확률을 내놓는 모델
결정 모델은 글을 생성하지 않고, "이 상태가 주어졌을 때 각 선택지가 맞을 확률"을 숫자로 돌려줍니다.
일반 LLM은 "이 문의는 환불 건인가요?"에 문장으로 답합니다. 결정 모델은 {"refund": 0.92}처럼 확률을 반환합니다. 요청은 하나의 state(텍스트, 선택적으로 이미지)와 여러 questions로 구성되고, 하나의 shared-prefix prefill로 한 번에 답합니다. 질문 유형은 noul(예/아니오), choice(선택지 중 하나), score(순서 있는 등급) 세 가지입니다.
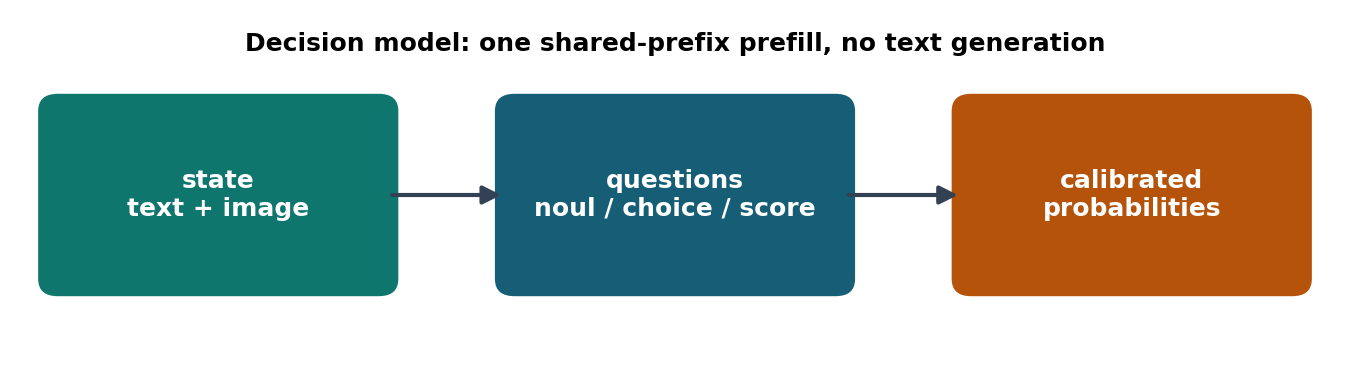
실무 이점은 두 가지입니다. 출력 토큰이 없어 비용과 지연이 예측 가능하고, 보정된 확률로 자동 처리와 사람 검토를 임계값으로 나눌 수 있습니다.
bison-1, Decision Index 76점으로 19개 모델 중 1위
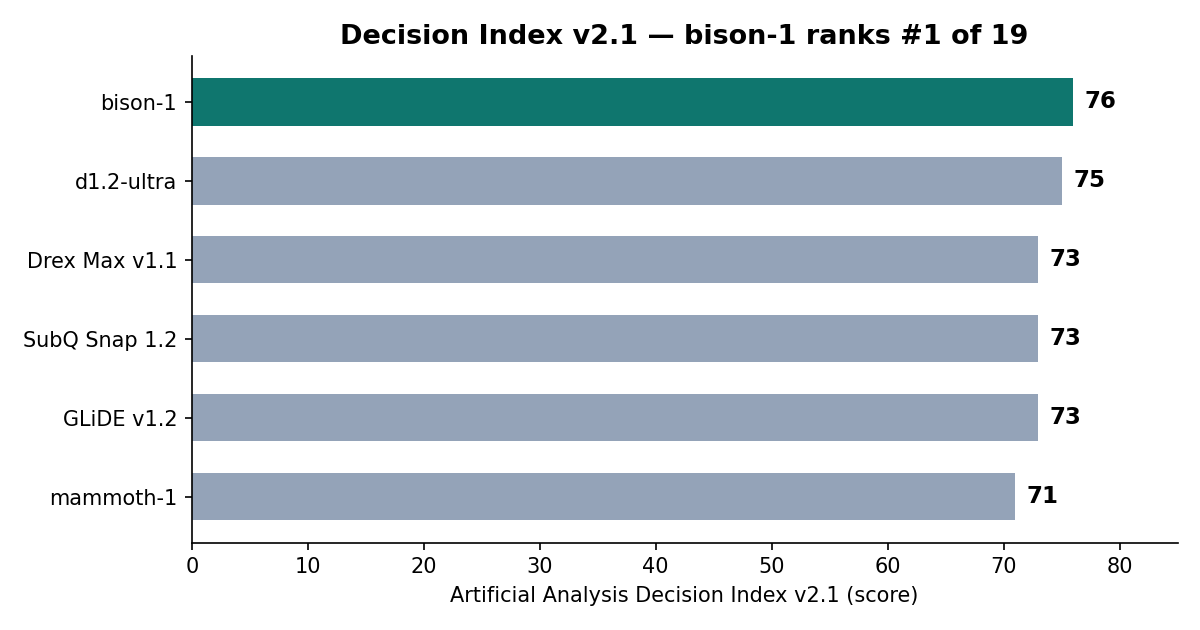
bison-1은 Artificial Analysis Decision Index v2.1(2026년 11월 19일 측정)에서 76점을 받아 19개 결정 모델 중 1위입니다.
2위는 Liquid AI d1.2-ultra(75점), 공동 3위는 Drex Max v1.1·SubQ Snap 1.2·GLiDE v1.2(이상 73점), 기존 mammoth-1은 71점입니다.
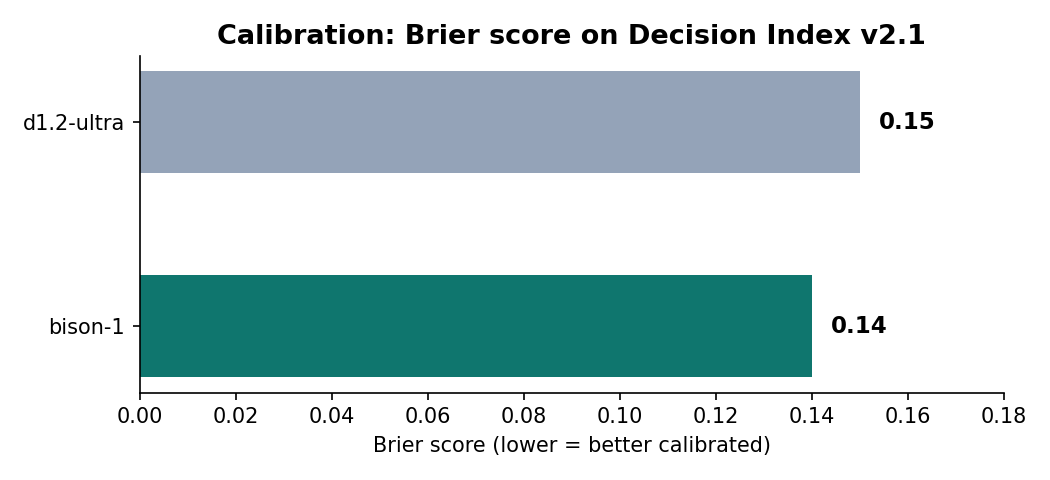
세부 벤치마크도 확인했습니다. bison-1은 When2Call 98점, EvalSafe-O*NET-AA 93점, HLE-MultiChoice v1.1 51점, AA-Symmetry v1.1 89점으로 모두 1위였고, AA-Omniscience-Decision v1.1은 60점으로 11위였습니다. 보정 품질도 1위입니다. Brier 점수는 bison-1이 0.14로 인덱스 내 최저, d1.2-ultra가 0.15입니다. Brier 점수는 낮을수록 확신도와 실제 정답률이 가깝다는 뜻입니다.
Qwen4-Max 가격·벤치마크 정리처럼, 점수보다 내 작업에서의 보정 품질과 비용을 함께 보는 편이 안전합니다.
컨텍스트 16k에서 128k로, 8배가 바꾸는 것
두 신모델의 컨텍스트는 131,072 토큰(128k)으로, 이전 세대 mammoth-1·elephant-1의 16k보다 8배 깁니다.
Baseten이 드는 사례가 직관적입니다. 청구서는 결제 준비가 된 것처럼 보여도, 앞의 이메일에서 주문이 취소됐다면 결제를 거절해야 합니다. 기록을 잘라내고 요약하면 그 단서가 사라집니다. 128k면 정책 문서나 대화 기록 전체를 넣고 판단할 수 있습니다.
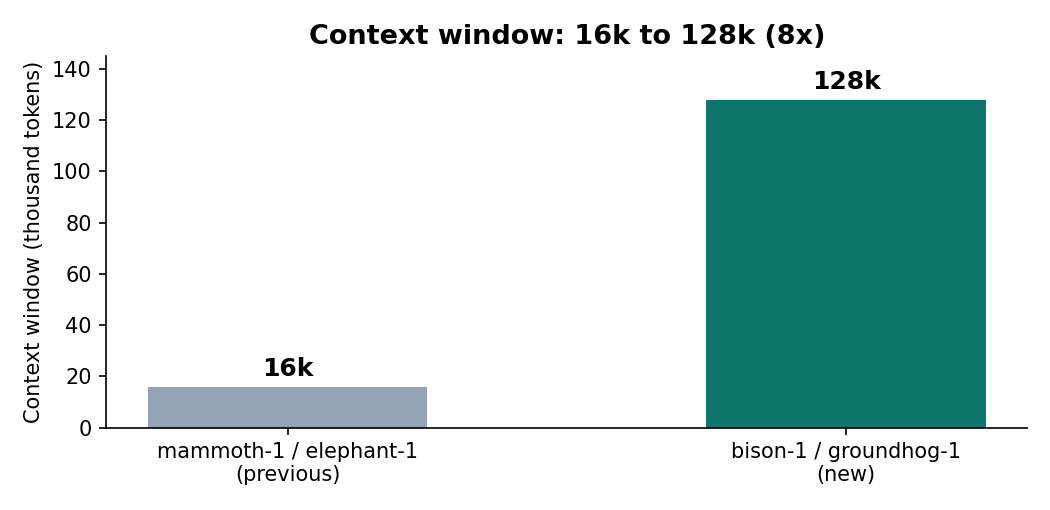
긴 컨텍스트 성능은 Baseten 자체 측정값입니다. 128k 토큰 기준 LongMemEval M은 bison-1 84.8·groundhog-1 77.4, LongMemEval S는 bison-1 87.1·groundhog-1 79.3이었습니다. 제3자 측정이 아니라 Baseten이 직접 돌린 결과이므로 비교용으로만 보는 편이 좋습니다. 128k를 넘는 입력은 거절되니 호출 전에 길이를 확인해야 합니다.
가격과 라인업: 같은 가격, 다른 자리
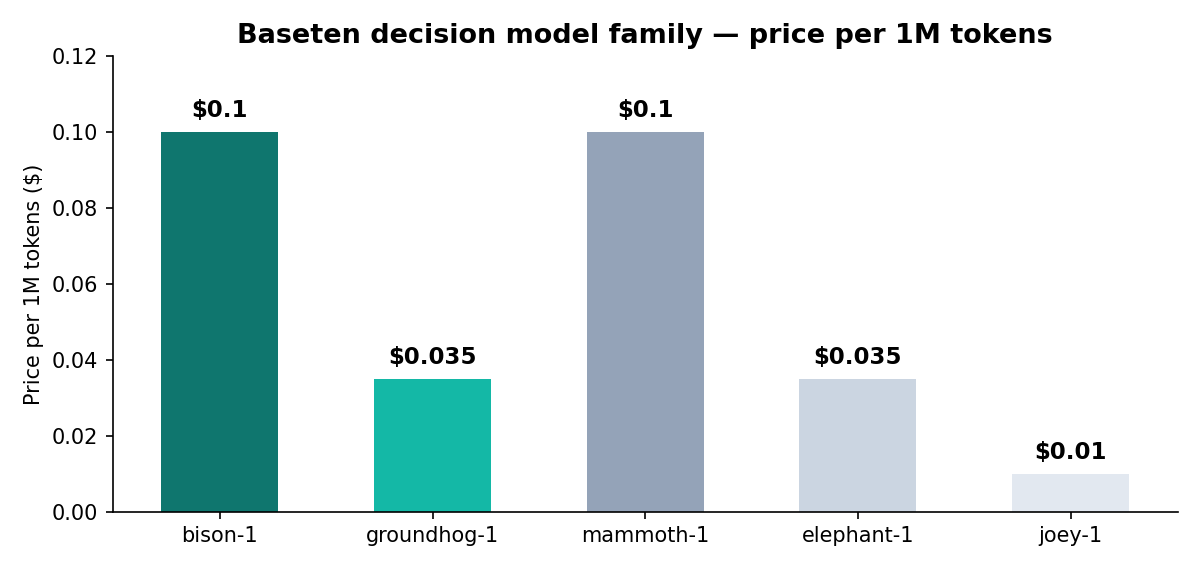
가격은 이전 세대와 동일합니다. bison-1은 100만 토큰당 $0.10, groundhog-1은 $0.035입니다.
bison-1은 mammoth-1($0.10)과, groundhog-1은 elephant-1($0.035)과 같은 가격이고, 가장 저렴한 joey-1은 $0.01입니다. 최고 정확도와 긴 컨텍스트면 bison-1, 긴 컨텍스트를 낮은 지연·비용으로 쓰려면 groundhog-1입니다.
| 모델 | 파라미터 | 베이스 | 컨텍스트 | 100만 토큰당 가격 | Decision Index v2.1 |
|---|---|---|---|---|---|
| bison-1 | 31B | Gemma 4 31B | 128k | $0.10 | 76 (1위) |
| groundhog-1 | 26B MoE, 약 4B active | Gemma 4 26B-A4B | 128k | $0.035 | 아직 미측정 |
| mammoth-1 | 27B | Qwen | 16k | $0.10 | 71 |
| elephant-1 | 9B | Qwen | 16k | $0.035 | 미공개 |
groundhog-1의 Decision Index 점수는 아직 없습니다. Baseten은 mammoth-1 수준일 것으로 "예상"한다고만 밝혔습니다. 이번 쌍은 이전 세대(Qwen 기반)와 달리 Gemma 4 기반이고, 라이선스는 Gemma 4가 Apache 2.0, Baseten 수정분은 MIT입니다.
토리스의 판단
토리스는 이 출시를 "챗봇 대체"가 아니라 "운영 판단의 자동화 부품" 으로 본다. 새 프로젝트라면 bison-1이 기본 선택입니다.
- 지금 써 볼 만한 일: 문의 분류, 담당 팀 라우팅, 긴급도 점수, 스팸·탈옥 가드레일 같은 반복 판단. 확률 임계값으로 자동 처리와 사람 검토를 나누면 운영 규칙을 세우기 쉽습니다.
- bison-1부터: 정확도와 보정 품질이 둘 다 1위이고 가격도 mammoth-1과 같습니다.
- groundhog-1은 비용 최적화용: 같은 128k 컨텍스트를 3분의 1 가격에 쓰되, 공식 점수가 나올 때까지 내 데이터로 bison-1과 나란히 측정해 보는 편이 안전합니다.
- 아직 맡기지 말 것: 128k를 넘는 입력, 임계값을 검증하지 않은 자동 결제·환불 승인, 한국어 판단 성능이 확인되지 않은 업무입니다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾