TensorRT-LLM 1.3.0, 엔진 빌드 없이 PyTorch만으로 서빙하기
NVIDIA TensorRT-LLM 1.3.0이 11월 20일 나왔다. TensorRT 엔진 백엔드를 없애고 PyTorch만 남겼고, trtllm-build도 사라졌다. 깨지는 13가지와 마이그레이션 방법을 정리했다.
Q. TensorRT-LLM 1.3.0으로 올리면 기존 서빙 스크립트가 그대로 돌아가나요? 아니요, 그대로는 안 돌아갑니다. 11월 20일 나온 v1.3.0은 TensorRT 엔진 백엔드를 아예 없애고 PyTorch를 유일한 실행 백엔드로 삼았습니다.
trtllm-build와LLM(backend="tensorrt")같은 기존 진입점이 사라졌으니, 올리기 전에 마이그레이션 가이드를 보고 스크립트를 고쳐야 합니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준이다. 모든 수치와 변경 사항은 NVIDIA TensorRT-LLM GitHub 저장소의 v1.3.0 릴리스 노트(2026년 11월 20일 02:45 UTC 게시)와 공식 마이그레이션 가이드를 직접 열어 확인했다.
30초 요약
- PyTorch가 유일한 백엔드: TensorRT 엔진 백엔드가 제거됐고,
trtllm-build·TrtLlmArgs·BuildConfig·레거시 C++ Executor API가 사라졌다. - 체크포인트 직접 로드: Hugging Face 체크포인트를 변환 없이
tensorrt_llm.LLM으로 바로 띄울 수 있다.LLM(backend="tensorrt")는ValueError를 낸다. - 깨지는 변경 13개: 제거 8개, 동작 변경 5개다. logprobs는 100으로 제한되고, KV 캐시 전송 타임아웃 기본값은 60초가 됐다.
- 새 모델 대거 추가: DeepSeek-V4·Kimi K3·Qwen3.5·MiniMax-M3·GLM-5 계열이 Blackwell·Rubin에서, Qwen3.5·Nemotron Nano Omni·Laguna가 Hopper에서도 지원된다.
가장 큰 변화: TensorRT 엔진 백엔드가 사라졌다
TensorRT-LLM은 이름과 달리 이제 TensorRT 엔진을 쓰지 않는다. v1.3.0부터 PyTorch가 유일한 실행 백엔드다. 기존에는 Hugging Face 체크포인트를 변환하고 trtllm-build로 .engine 파일을 미리 컴파일해야 서빙할 수 있었다. 이제 그 단계가 통째로 없어졌다.
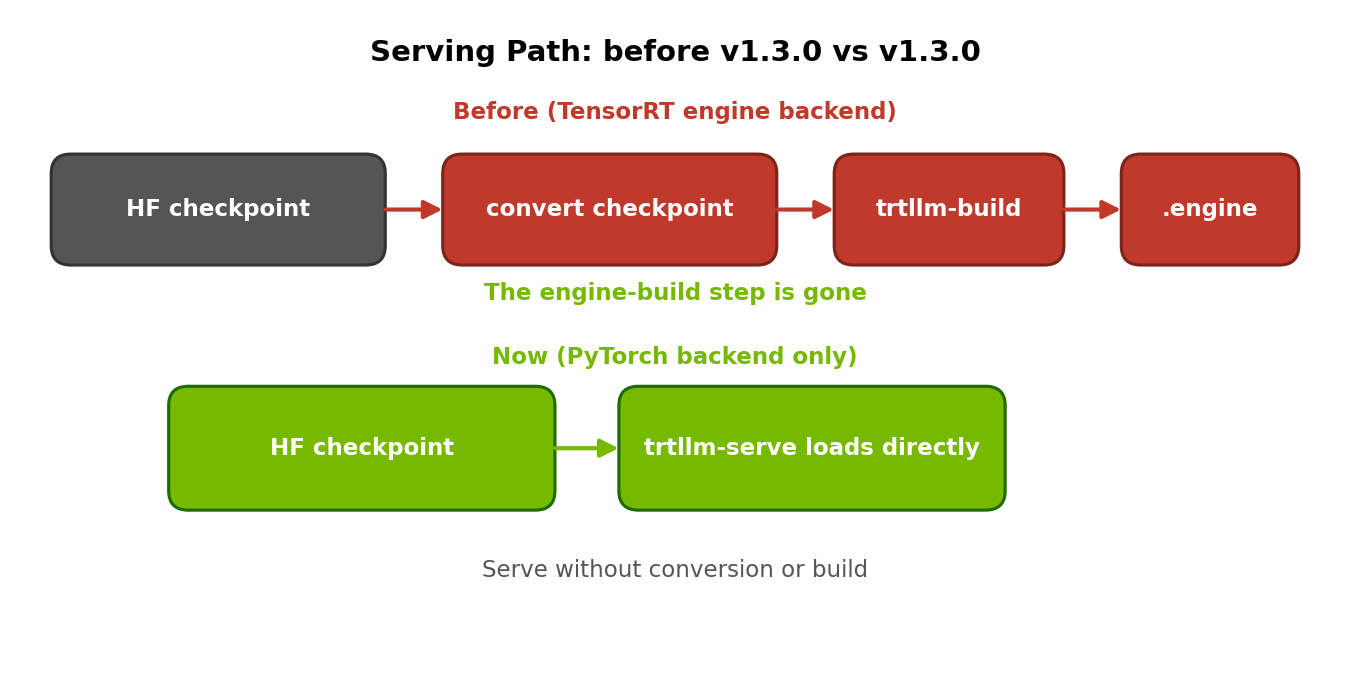
마이그레이션은 짧다. Python API에서는 backend 인자를 빼면 된다. PyTorch가 기본값이라 from tensorrt_llm import LLM으로 그대로 쓰면 되고, TrtLlmArgs 대신 기본값인 TorchLlmArgs를 쓴다. CLI에서는 --backend pytorch가 기본값이라 따로 지정할 필요가 없다. 모델별 convert_checkpoint.py도 필요 없고, tensorrt pip 의존성 자체가 빠졌다.
깨지는 것 13개, 어디부터 고치나
깨지는 변경은 13개다. 제거 8개, 동작 변경 5개다.
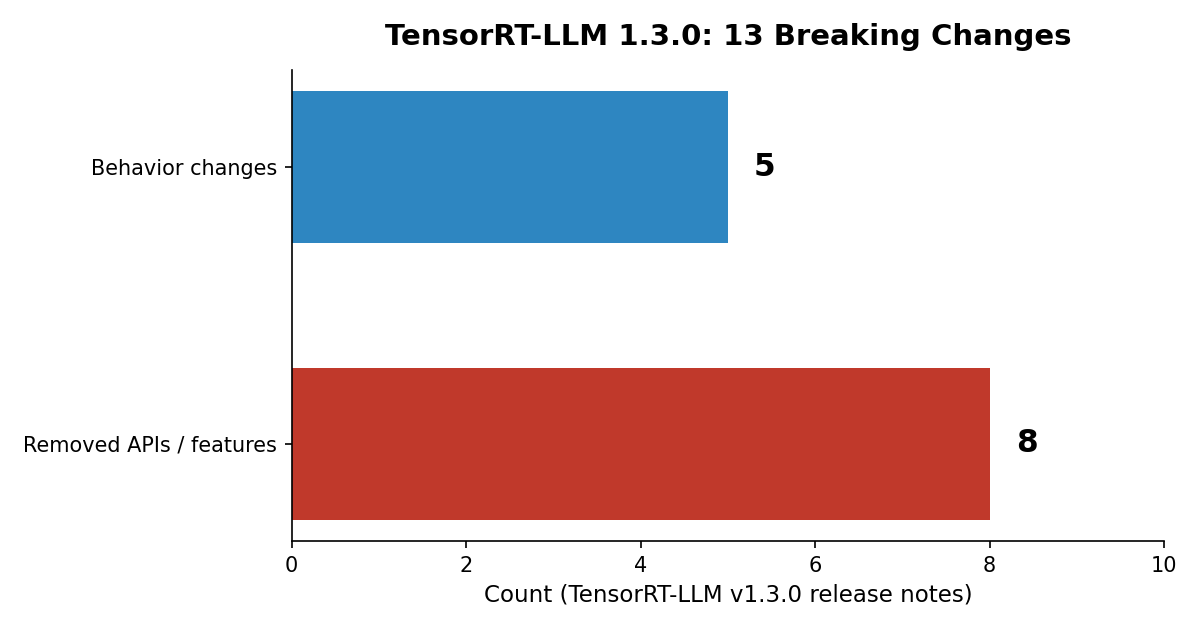
제거된 것은 TensorRT 백엔드, 레거시 C++ Executor와 런타임·배치 매니저 API, TensorRT 엔진 Triton 백엔드 모델, TRTLLMSampler(TorchSampler만 남음), 2개 모델 추론 디코딩, AutoDeploy·Star Attention·WIDEEP, /perf_metrics 엔드포인트, 구식 옵션들이다. /perf_metrics 대신 X-TRTLLM-return-metrics: 1 헤더를 쓴다.
동작 변경 5개는 더 조용히 문제를 일으킨다. 명시적 CLI 플래그가 YAML 설정보다 우선하고, KV 캐시 전송 타임아웃 기본값이 60초로 생겼다. 요청별 채팅 템플릿은 기본 비활성화됐고, 쓰려면 --allow_request_chat_template을 켜야 한다. logprobs는 100을 넘기면 ValueError가 나고, 동적 추론 필드는 acceptance_rate_window_size·acceptance_rate_threshold로 이름이 바뀌었다.
TRITON MoE 백엔드는 이번 버전에서 바로 사라지진 않지만 폐기 상태로, 3개월 뒤 제거된다. 대안은 moe_config.backend="CUTLASS"다. --backend·--moe_cluster_parallel_size·--metrics-log-interval 옵션도 폐기됐다.
새로 지원하는 모델과 GPU 세대
모델 지원은 Blackwell 중심으로 넓어졌고, Rubin은 프리뷰로 들어왔다.
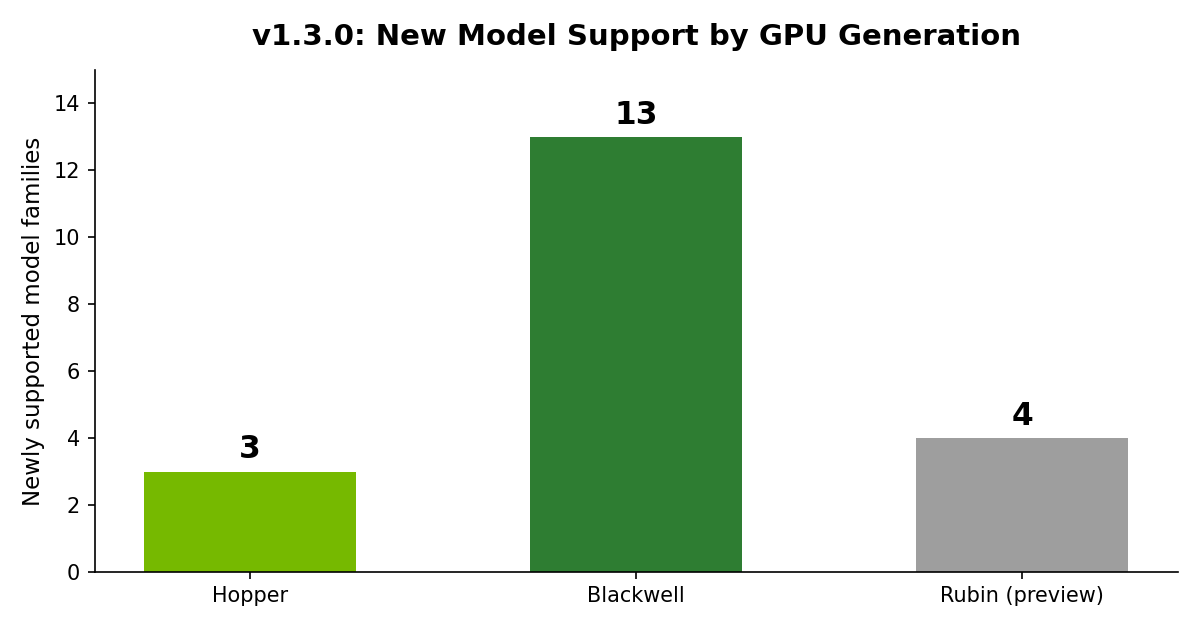
Blackwell에서 새로 지원되는 모델은 DeepSeek-V4, Kimi K3(멀티모달·멀티노드 서빙 포함, DEP16은 GB300급 GPU 메모리 필요), Qwen3.5(MTP·NVFP4 포함), Qwen3.6, Qwen3.8-Flash-Next, MiniMax-M3, GLM-5, GLM-5.2, Kimi-K2.5, Step-3.7-Flash, Nemotron Nano Omni, Gemma 4(멀티모달 포함), Laguna까지 13개 계열이다. Hopper는 Qwen3.5·Nemotron Nano Omni·Laguna 3개 계열, Rubin 프리뷰는 DeepSeek-V4·Kimi K3·Qwen3.5·MiniMax-M3 4개 계열이다.
한국 개발자에게 직접 닿는 점은 최신 중국 오픈 모델(DeepSeek-V4, Kimi K3, Qwen3.5, GLM-5 계열)을 NVIDIA 공식 엔진으로 바로 서빙할 수 있게 됐다는 것이다. Qwen4-Max 가격·벤치마크 정리에서 봤듯 Qwen 계열은 API로 쓰기에도 싸지만, 자체 GPU가 있다면 같은 계열을 띄우는 선택지도 생겼다. 다만 Rubin은 프리뷰라 프로덕션 단계는 아니다.
서빙 API가 넓어졌다: Anthropic Messages API와 gRPC
Anthropic Messages API(/v1/messages)가 추가돼 Claude API 형식 클라이언트를 그대로 붙일 수 있고, Responses API도 확장됐다. gRPC 서버와 멀티프로세스 HTTP 프론트엔드도 들어왔다.
요청별 priority와 이름 있는 함수의 tool_choice, Prometheus 메트릭, /start_profile·/stop_profile 프로파일링 엔드포인트, trtllm-serve의 --served_model_name·--kv_cache_dtype·--middleware 옵션도 추가됐다.
KV Cache Manager V2가 대부분 모델 계열에서 기본이 됐고, NVFP4 cold-page 압축과 FlexKV·LMCache 커넥터가 추가됐다. 양자화는 MXFP8(W8A8)과 Marlin 기반 W4A16 NVFP4가 추가돼 NVFP4 체크포인트를 Hopper와 Ada Lovelace에서도 돌릴 수 있다.
업그레이드 전 체크리스트: 의존성 버전과 알려진 문제
올리기 전에 의존성부터 확인한다. 베이스 이미지는 nvcr.io/nvidia/pytorch:26.09-py3로 바뀌었고, CUDA Toolkit 13.4.1, PyTorch 2.14.0, Python 3.10·3.12를 쓴다. transformers는 5.5.4, flashinfer-python은 0.6.18, triton은 3.8.0, NCCL은 2.31.2다. TensorRT·NVIDIA ModelOpt·ONNX는 더 이상 의존성이 아니다.
알려진 문제도 있다. Kimi-K3 NVFP4는 번들된 transformers 버전에서 토크나이저 로딩에 실패할 수 있고, GLM-5.2 NVFP4는 GB200에서 TP=8일 때 max_num_tokens가 4096을 넘으면 웜업 중 세그폴트가 날 수 있다. /v1/responses는 일부 입력 형식·스트리밍·도구 호출에 호환성 공백이 있다.
텔레메트리도 기본 켜짐이다. 끄려면 TRTLLM_NO_USAGE_STATS=1이나 DO_NOT_TRACK=1을 설정하거나 CLI에 --no-telemetry를 넘긴다.
토리스의 판단
TensorRT-LLM 1.3.0은 "업그레이드하면 빨라진다"는 릴리스가 아니라 "올리면 스크립트를 고쳐야 한다"는 릴리스다. 판단 기준은 하나다. 지금 TensorRT 엔진 백엔드나 trtllm-build에 의존하는 배포 파이프라인이 있는가.
있다면, 올리기 전에 마이그레이션 가이드를 보고 backend 인자·TrtLlmArgs·trtllm-build 호출을 먼저 고친다. logprobs 100 제한과 KV 전송 60초 타임아웃, 채팅 템플릿 opt-in 같은 조용한 변경도 테스트에서 한 번씩 밟아본다.
없다면 1.3.0은 좋은 출발점이다. 체크포인트 변환 단계가 없어졌고, DeepSeek-V4·Kimi K3·Qwen3.5 같은 최신 모델이 공식 지원되며, Anthropic Messages API 덕분에 Claude 형식 클라이언트도 그대로 붙는다. 다만 Rubin은 프리뷰이고, 알려진 문제는 피해서 간다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾