TML-d24 가변 루프 모델, 반복 횟수별 성능·실행법 정리
Thinking Machines Lab이 11월 20일 공개한 TML-d24-varloop-research는 중간 12개 레이어를 1~5회 반복하는 오픈웨이트 연구 모델이다. 패스 수별 벤치마크와 로컬 실행 조건을 모델 카드 기준으로 정리했다.
Q. 같은 모델인데 추론 때 레이어를 몇 번 더 돌리면 성능이 얼마나 달라지나요? 꽤 크게 달라집니다. Thinking Machines Lab이 11월 20일 공개한 TML-d24-varloop-research는 가운데 12개 레이어를 추론 시점에 1~5회 반복하는 오픈웨이트 연구 모델로, DeepSWE v1.1이 1회 패스 0.7%에서 3회 패스 47.4%로 뛰고, SWE-bench Verified도 56.3%에서 78.7%로 오릅니다. 다만 3회 외 패스 수는 포스트트레이닝 기준이 아니라 예측 불가하게 동작할 수 있어 연구용입니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준이다. 수치는 Hugging Face에 올라온 TML-d24-varloop-research 모델 카드(11월 20일)를 직접 열어 확인했다. 벤치마크는 발표사 자체 측정이라 조건이 모델마다 다를 수 있고, 토리스가 직접 실행한 결과는 아니다. 일부 벤치마크 셀은 모델 카드에 아직 결과가 비어 있어 이 글에서는 결과가 있는 항목만 다룬다.
30초 요약
- TML-d24-varloop-research는 11월 20일 공개된 Apache 2.0 오픈웨이트 연구 모델이다. Inkling 2 Mini의 형제 모델로, 루프 횟수를 추론 시점에 1~5회로 고를 수 있다.
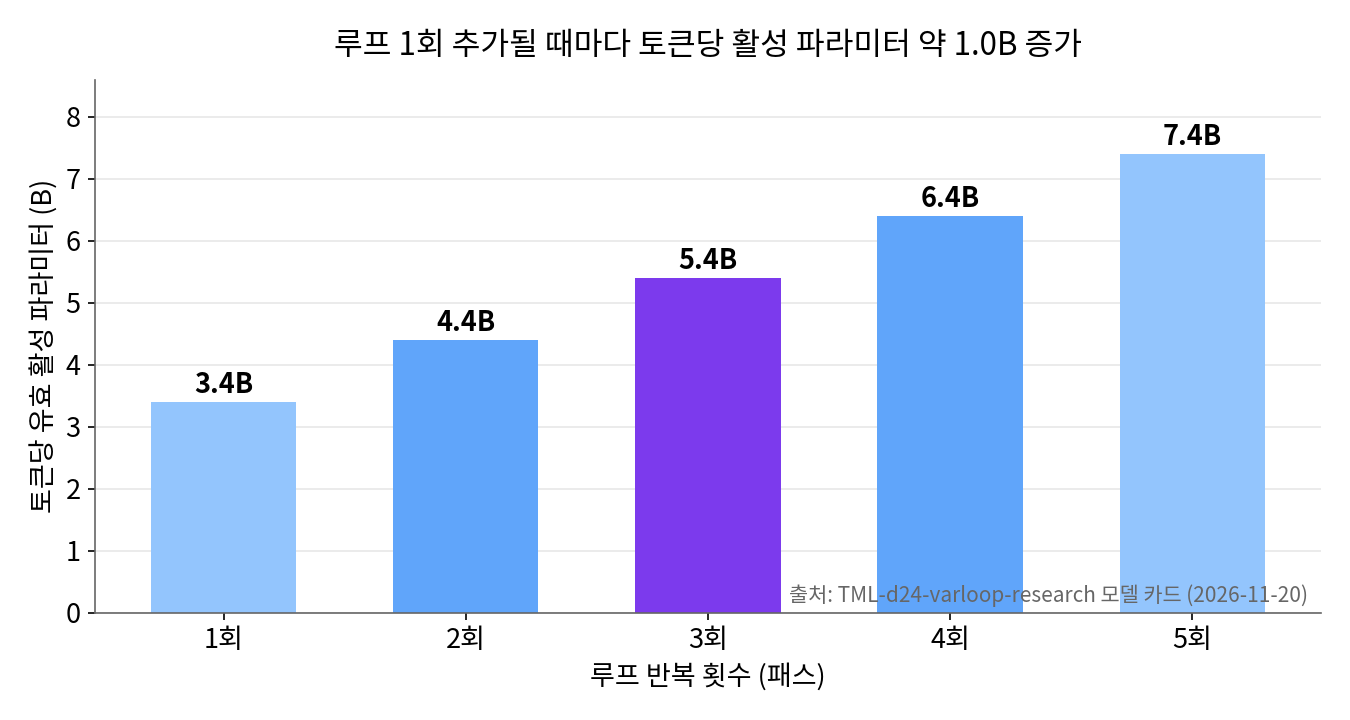
- 24개 레이어 중 가운데 12개를 가중치 공유로 반복한다. 총 파라미터 26.4B, 토큰당 활성 3.4B이며, 루프 1회마다 토큰당 유효 활성 파라미터가 약 1.0B씩 늘어난다.
- 성능은 1회에서 3회로 갈 때 가장 크게 오른다. DeepSWE v1.1 0.7%→47.4%, MRCR v2 27.2%→89.2%, BrowseComp 29.4%→65.7%다. 3회에서 5회로는 오름폭이 작다.
- 체크포인트 약 20GB, GPU·통합 메모리 32GB 이상이면 로컬 실행이 가능하다. API는 없고 오픈웨이트만 배포되며, vLLM·SGLang·Ollama 등을 지원한다.
- 포스트트레이닝은 3회 패스 기준이라, 다른 패스 수에서는 예측 불가하게 동작할 수 있다. 발표사는 프로덕션에 Inkling 2 Mini를 권한다.
가변 루프란 — 같은 레이어를 1~5회 돌린다
TML-d24의 핵심은 루프 횟수를 고정하지 않고 추론 시점에 고르게 한 설계다.
24개 디코더 레이어 중 앞 6개와 뒤 6개는 한 번씩만 돌고, 가운데 12개는 가중치를 공유한 채 1~5회 반복한다. 저장된 레이어는 24개지만 토큰 하나가 거치는 레이어 적용 횟수는 1회 패스 24회, 3회 패스 48회, 5회 패스 66회가 된다. 각 레이어에서는 토큰마다 128개 전문가 중 8개가 선택되는 희소 MoE 구조이고, 이미지는 비전 트랜스포머로 인코딩해 텍스트와 함께 처리하는 멀티모달 모델이며, 컨텍스트는 최대 100만 토큰이다.
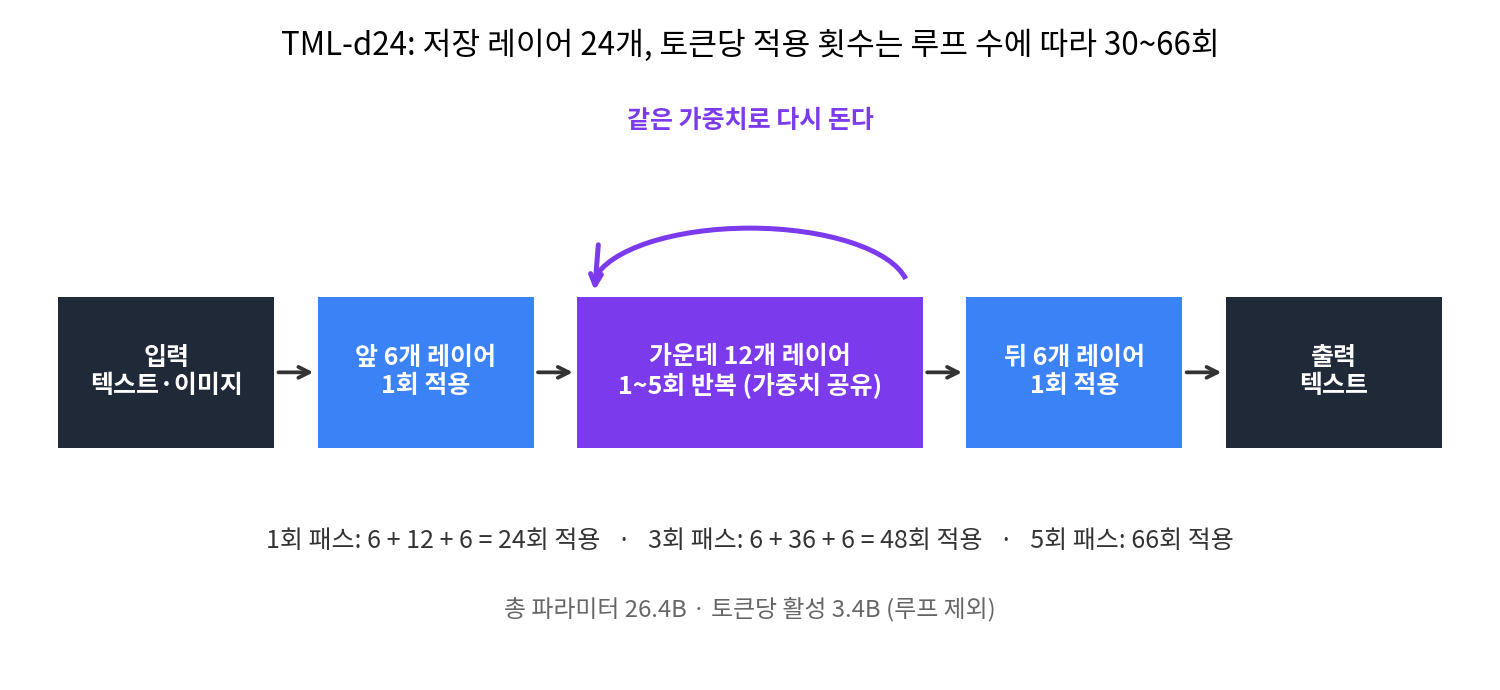
형제 모델 Inkling 2 Mini 정리가 루프를 3회로 고정한 제품 지향 모델이라면, TML-d24는 루프 수만 바꿔가며 '계산을 더 하면 능력이 어떻게 바뀌는가'를 재기 위한 연구용 모델이다.
루프 횟수별 벤치마크 — 1회에서 3회가 가장 큰 폭
루프를 늘리면 성능이 오르지만, 이득의 대부분은 1회에서 3회 사이에 몰려 있다.
가장 극적인 항목은 에이전트 코딩이다. DeepSWE v1.1은 1회 0.7%에서 2회 28.3%, 3회 47.4%로 뛰고 5회 48.2%에서 멈춘다. SWE-bench Verified도 56.3%→76.5%→78.7%→79.6%로 2회 이후 완만해진다. 장문 기억력 MRCR v2(256K–512K)는 27.2%에서 3회 89.2%, 4회 93.4%까지 오르고, 검색·도구 활용 BrowseComp는 29.4%에서 5회 71.0%까지 꾸준히 오른다.
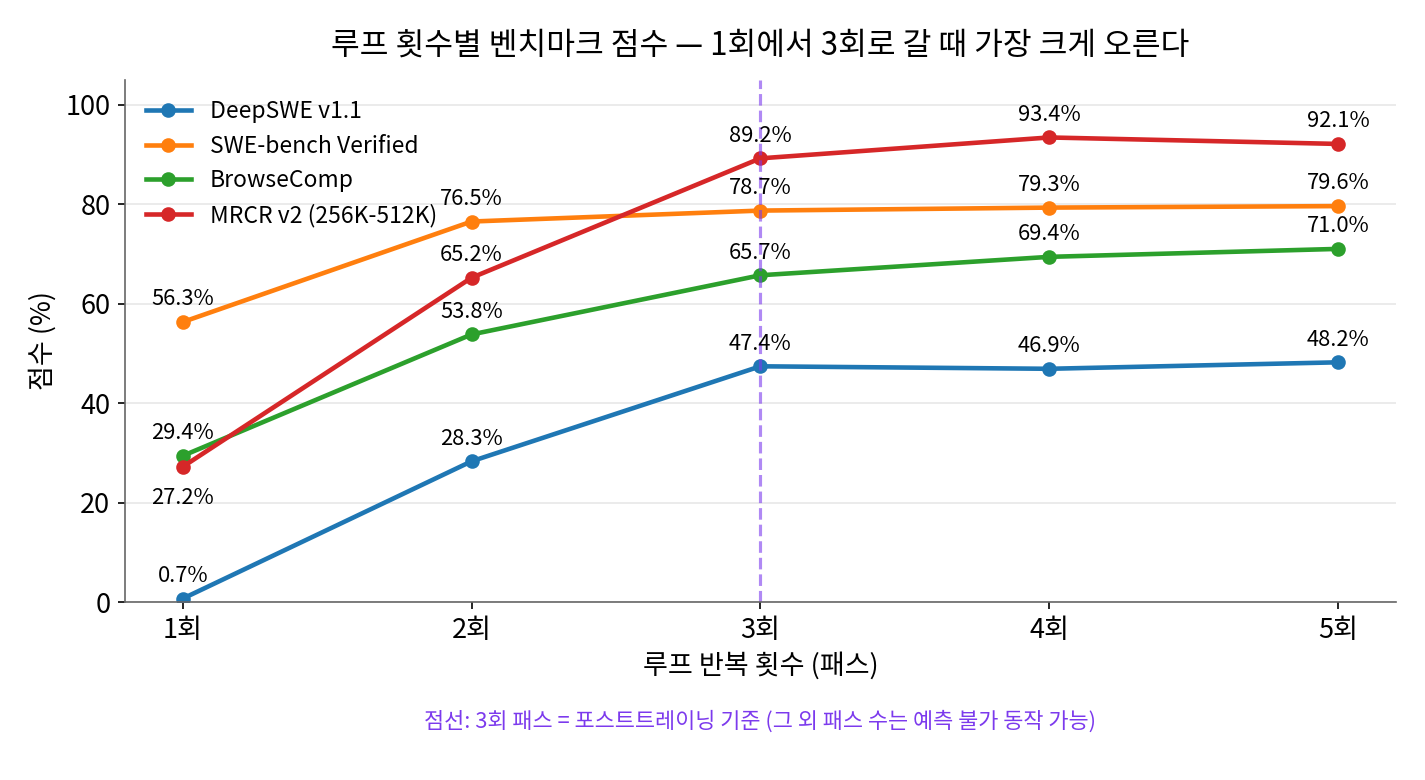
지식·추론 쪽도 같은 패턴이다. GPQA Diamond는 1회 69.6%에서 3회 84.2%로 오르고, HLE(텍스트 전용)는 10.5%에서 3회 24.9%다. 3회 기준 TML-d24는 Inkling 2 Mini와 거의 같은 수준이지만, 발표사가 직접 비교를 주의하라고 한 만큼 동등하다고 단정하지는 않는 편이 맞다.
1회 패스는 DeepSWE 0.7%, HLE 10.5%처럼 사실상 에이전트 작업이 안 되는 수준이다. 루프가 이 모델의 능력 자체를 만든다. 반대로 4~5회로 늘려도 점수는 거의 그대로라, 연산량을 더 쓰는 만큼의 이득은 작다.
파라미터 숫자 읽기 — 총합·활성·유효 활성
26.4B라는 숫자는 저장된 크기이고, 실제로 토큰마다 쓰이는 양은 루프 수에 따라 3.4B에서 7.4B까지 달라진다.
모델 카드가 구분하는 숫자는 세 가지다. 총 파라미터 26.4B, 토큰당 활성 파라미터 3.4B, 그리고 루프 반복까지 합친 토큰당 유효 활성 파라미터다. 루프 1회를 추가할 때마다 유효 활성이 약 1.0B씩 늘어나 1회 3.4B, 3회 5.4B, 5회 7.4B가 된다. 같은 가중치를 다시 쓰기 때문에 저장 용량은 늘지 않고, 계산량만 늘어나는 구조다.
정밀도는 훈련 단계부터 설계됐다. 전문가 레이어는 NVFP4 4비트, 마지막 4개는 MXFP8 8비트, 나머지는 BF16이며, 체크포인트(약 20GB)는 훈련과 같은 정밀도라 추가 양자화가 필요 없다.
로컬에서 돌리는 법 — 20GB, 32GB 이상, API는 없다
API가 없어 직접 내려받아 돌려야 하고, 메모리 32GB 이상 머신이 사실상 하한선이다.
최소 조건은 GPU 또는 통합 메모리 32GB 이상인 단일 머신이다. 예시 구성은 NVIDIA DGX Spark 1대, VRAM 32GB 이상 GPU(GeForce RTX 5090·RTX PRO 6000 Blackwell), 통합 메모리 32GB 이상 애플 실리콘 맥(맥 미니 등)이다. 체크포인트 약 20GB 외에 남는 메모리는 컨텍스트와 KV 캐시가 차지한다.
지원 프레임워크는 Hugging Face, SGLang, vLLM, TokenSpeed, NVIDIA Dynamo, Unsloth·llama.cpp(GGUF), Llama App, Ollama·Exo Labs(애플 실리콘)다. 포스트트레이닝 도구로는 Miles와 SkyRL이 안내돼 있다. Tinker를 포함한 어떤 API로도 제공되지 않으니 로컬 실행이 유일한 경로다. 비슷한 크기에서 로컬로 돌리는 오픈웨이트를 찾는다면 Olala mini 7A1B 정리도 참고할 만하다.
연구용이라는 경고 — 3회 외 패스 수는 예측 불가
이 모델은 제품을 위한 것이 아니라, 루프 자체를 연구하기 위한 것이다.
프리트레이닝과 미드트레이닝 전반은 Inkling 2 Mini와 공유하고, 이후 미드트레이닝에서 1~5회 패스를 1:2:6:2:1 비율로 섞어 학습한 뒤 포스트트레이닝은 3회 패스로만 했다. 3회 패스가 학습의 대부분을 차지했기 때문에 다른 패스 수의 성능은 그 패스 수에 맞춰 따로 학습한 모델보다 낮게 나올 수 있다. 모델 카드는 '3회 외 패스 수에서는 예측 불가하게 동작할 수 있다'고 직접 적었다.
안전성 평가도 같은 선상이다. Inkling 2 Mini와 같은 출시 전 평가를 거쳤고, CBRN·사이버 평가에서는 이미 공개된 모델들보다 능력이 낮으며, 유해 요청 거부는 Inkling 2 Small과 비슷한 수준이다. 발표사는 프로덕션·사용자 대면 앱에 배치하지 말라고 했다.
연구자에게 이 모델의 가치는 통제된 비교다. 같은 가중치로 루프 수만 바꿔 '계산을 더 하면 능력이 얼마나 느는가'를 잴 수 있다. Inkling 2 Mini 정리에서 다룬 CoT 길이 변화 같은 현상도 이 모델로 직접 재볼 수 있다.
토리스의 판단
토리스는 TML-d24를 '써보라'는 모델이 아니라 '재보라'는 모델로 본다. 같은 가중치로 루프 수만 바꿀 수 있다는 점이 이 모델의 전부다. 1회에서 3회로 갈 때 코딩·검색·장문 기억력이 크게 오르고, 3회 이후 이득이 급격히 줄어든다는 곡선은 루프 모델의 반복 횟수를 정하는 기준점이 된다.
실무에서는 Inkling 2 Mini가 답이다. 3회 패스로 고정하고 포스트트레이닝까지 마쳤으며 API도 있다. TML-d24는 루프 자체를 연구하거나, 내 에이전트 작업에서 패스 수와 비용의 교환비를 직접 재보고 싶은 사람을 위한 모델이다. 그 경우에도 3회 패스를 기준으로 삼고, 다른 패스 수는 '학습이 덜 된 영역'이라는 단서를 붙여 읽는 편이 안전하다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾