BitNet(microsoft/BitNet) — GPU 없이 CPU로 1비트 LLM·임베딩 돌리는 공식 추론 엔진
마이크로소프트 공식 1비트 LLM 추론 엔진 bitnet.cpp(microsoft/BitNet)의 x86 최대 6.17배 가속, 에너지 82% 절감 수치, BitNet-b1.58-2B-4T·임베딩·VibeASR.cpp 활용법과 제약을 정리했습니다.
Q. 비싼 GPU 없이 CPU만으로 대규모 언어 모델(LLM)을 쓸 만한 속도로 돌릴 수 있을까요? 네. 마이크로소프트가 공개한 공식 1비트 LLM 추론 프레임워크 **bitnet.cpp(
microsoft/BitNet)**를 쓰면, 가중치를{-1, 0, +1}삼진 값으로 표현한 1.58비트 모델을 CPU에서 무손실로 구동할 수 있습니다. 공식 문서 기준으로 x86 CPU에서 최대 6.17배, ARM CPU에서 최대 5.07배 속도를 끌어올리고, 단일 CPU에서 100B 모델도 초당 5~7토큰(사람 읽기 속도) 수준으로 돌릴 수 있습니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준
microsoft/BitNet공식 GitHub 저장소(42,353 Stars, 3,995 Forks, MIT 라이선스)와 README·API를 직접 확인해 작성했습니다. 커뮤니티별 실제 체감 속도(tok/s)는 CPU 세대·메모리 대역폭·스레드 수에 따라 달라지며, 저장소의 최신 커밋(0b341e5)은 2026년 7월 27일 기준입니다.
30초 요약
- 핵심 개념:
bitnet.cpp는llama.cpp와T-MAC룩업 테이블(Lookup Table) 커널을 기반으로 1.58비트(삼진) LLM과 임베딩·음성 모델을 CPU/GPU에서 빠르게 돌리는 공식 추론 엔진입니다. - 검증된 성능: 풀 프리시전 모델 대비 x86 CPU 2.37
6.17배 가속(에너지 71.982.2% 절감), **ARM CPU 1.375.07배 가속(에너지 55.470.0% 절감)**을 기록했습니다. - 2026년 확장 라인업:
BitNet-b1.58-2B-4T(2.4B) 외에도 CPU용 1비트 임베딩 모델(BitNet-embedding-0.6B/270M)과 실시간 다국어 음성인식 엔진VibeASR.cpp까지 생태계가 넓어졌습니다. - 적합한 대상: GPU 서버 비용을 줄이려는 1인 개발자, 엣지 디바이스·노트북 로컬 AI 환경, 개인 RAG 임베딩 파이프라인 구축 팀.
1. bitnet.cpp가 기존 양자화와 다른 이유
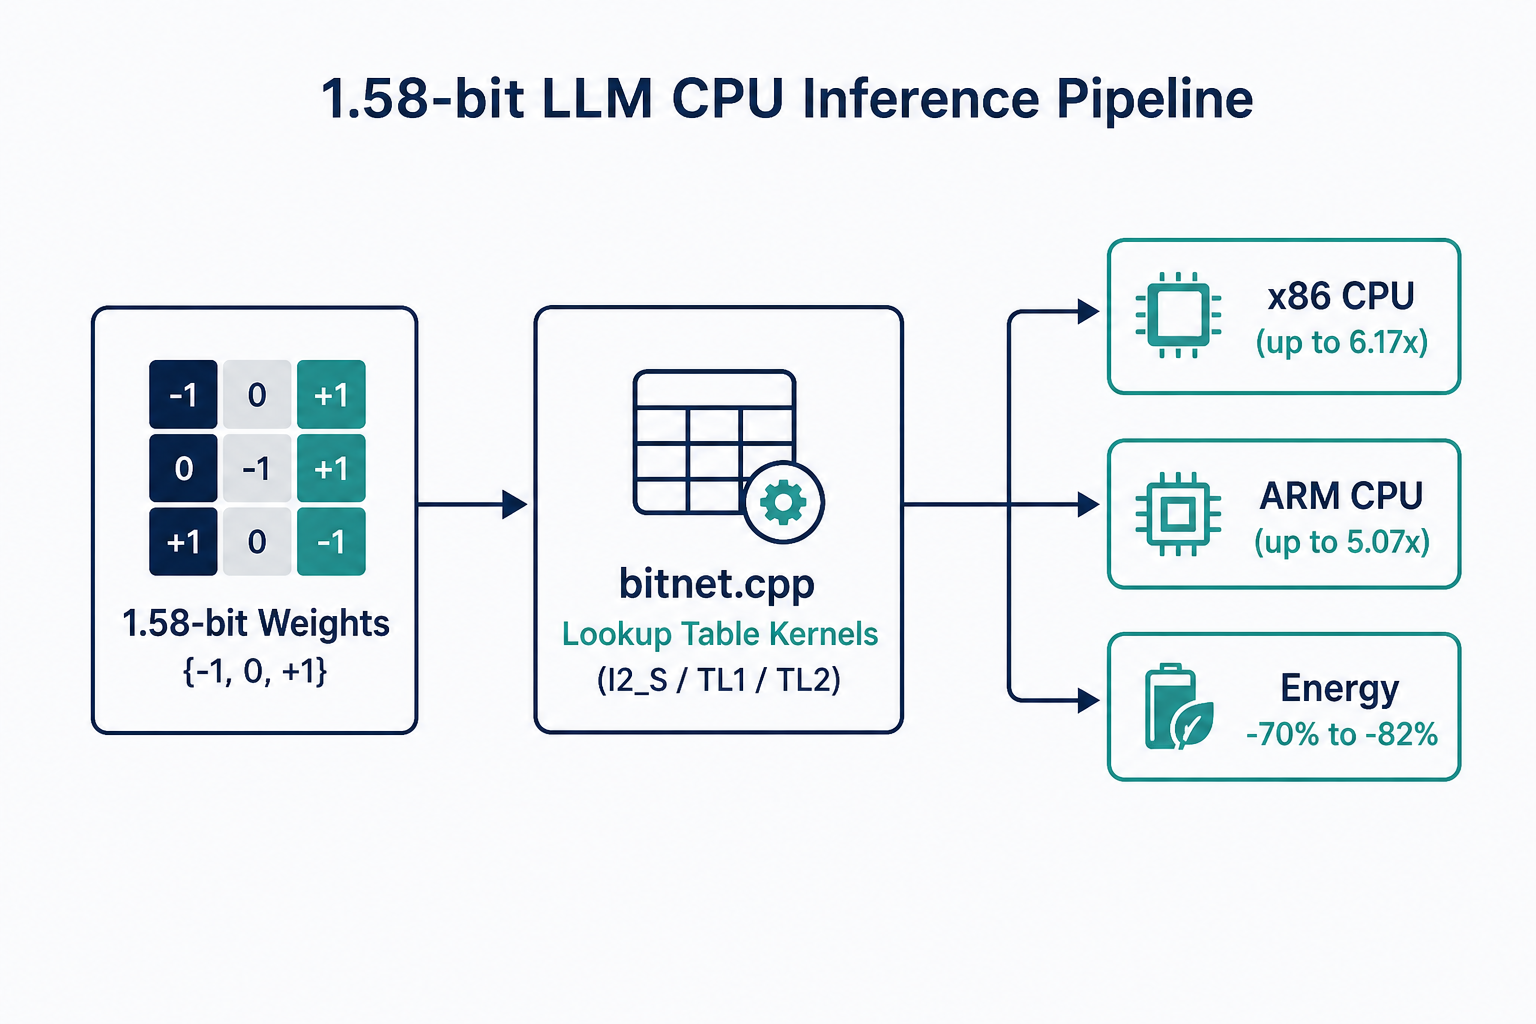
1.58비트(삼진) 모델은 사후 압축이 아니라 학습 단계부터 가중치를 {-1, 0, +1} 세 값으로 제한합니다. 일반적인 4비트·8비트 양자화는 16비트 모델을 나중에 깎아 내리는 방식이라 비트 수가 내려갈수록 정확도 손실이 커집니다. 반면 BitNet b1.58 아키텍처는 행렬 곱셈 대부분을 부동소수점 곱셈 대신 정수 덧셈·뺄셈으로 바꿀 수 있어 CPU 캐시와 연산 효율이 극적으로 올라갑니다.
bitnet.cpp는 이 구조를 실제 하드웨어에서 빠르게 뽑아내기 위해 I2_S, TL1, TL2 같은 전용 커널을 제공합니다. 2026년 11월 21일 기준 저장소는 42,353 Stars, 3,995 Forks, MIT 라이선스로 공개되어 있으며 C++(48.6%)과 Python(48.0%)으로 구성되어 있습니다.
2. CPU·ARM 성능과 에너지 절감 수치
별도 GPU 없이도 일반 노트북과 서버 CPU에서 읽기 가능한 수준의 토큰 속도와 큰 폭의 전력 절감을 얻습니다. 공식 저장소 Overview에 공개된 벤치마크 범위는 다음과 같습니다.
| 플랫폼 | 속도 향상 (풀 프리시전 대비) | 에너지 절감률 | 비고 |
|---|---|---|---|
| x86 CPU | 2.37x ~ 6.17x | 71.9% ~ 82.2% | I2_S, TL2 커널 지원 |
| ARM CPU | 1.37x ~ 5.07x | 55.4% ~ 70.0% | I2_S, TL1 커널 지원 |
| 100B 단일 CPU | 5~7 tokens/sec | - | 사람 읽기 속도와 유사한 수준 |
2026년 1월에는 타일링(tiling) 설정과 임베딩 양자화를 포함한 CPU 추론 최적화가 추가되어 기존 구현 대비 1.15x ~ 2.1x의 추가 속도 향상을 달성했습니다. 여기에 GPU 추론 커널(gpu/ 디렉터리)도 함께 제공되어 단일 환경에 묶이지 않습니다.
3. 2026년 공식 모델과 확장 생태계
LLM을 넘어 임베딩과 실시간 음성 인식(ASR)까지 1비트 CPU 생태계가 넓어졌습니다. 현재 공식 및 커뮤니티 지원 모델은 다음과 같이 나뉩니다.
| 모델명 | 파라미터 | 용도 | 주요 특징 |
|---|---|---|---|
BitNet-b1.58-2B-4T |
2.4B | 대화형 LLM | 4T 토큰 학습, 공식 첫 1.58비트 LLM |
BitNet-embedding-0.6B |
0.6B | 텍스트 임베딩 | F16 대비 prefill 1.42x~2.28x 가속 (x86 8스레드) |
BitNet-embedding-270M |
270M | 초경량 임베딩 | F16 대비 prefill 1.32x~1.74x 가속 (x86 8스레드) |
VibeASR.cpp |
- | 다국어 ASR | BitNet I2_S 기반 CPU 실시간 음성 인식 (RTF < 1) |
| 커뮤니티 모델 | 0.7B ~ 10B |
범용·실험 | Llama3-8B-1.58, Falcon3 패밀리(1B~10B) 등 |
특히 로컬에서 RAG나 문서 검색을 돌릴 때 임베딩 모델까지 GPU 메모리를 차지하던 부담을 CPU로 옮길 수 있다는 점이 실무에서 매력적입니다. 로컬 환경에서 소형 모델을 직접 학습·구동해 본 경험이 있다면 MiniMind-3 64M 로컬 학습 가이드나 Inkling 2 Mini 26B 루프 모델 정리와 함께 비교해 보셔도 좋습니다.
4. 로컬 설치 및 추론 실행 방법
Python 3.10 이상, CMake 3.22 이상, Clang 18 이상만 갖추면 소스에서 빌드해 바로 대화형 추론을 돌릴 수 있습니다. 윈도우 환경에서는 Visual Studio 2022의 C++ 데스크톱 개발·CMake·Clang 도구를 함께 설치하고 Developer Command Prompt에서 실행해야 합니다.
# 1. 저장소 클론
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet

# 2. 의존성 설치 (conda 권장)
conda create -n bitnet-cpp python=3.10
conda activate bitnet-cpp
pip install -r requirements.txt

# 3. 공식 2B 모델 다운로드 및 I2_S 커널 빌드
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s

# 4. 대화형 추론 실행
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "You are a helpful assistant" -cnv
run_inference_server.py를 쓰면 llama.cpp 내장 HTTP 서버 형태로 띄워 기존 OpenAI 호환 클라이언트와 연결하는 것도 가능합니다.
5. 도입 전 반드시 확인할 제약사항
기존 일반 가중치(FP16/BF16) 모델을 그대로 bitnet.cpp에 넣으면 1비트 효과를 얻을 수 없습니다. 반드시 BitNet b1.58 방식으로 학습되었거나 I2_S·TL1·TL2 포맷으로 변환된 전용 체크포인트를 써야 합니다. 또한 BitNet-embedding-0.6B/270M은 현재 표 기준으로 x86 I2_S 커널만 지원하고 ARM 커널은 아직 미지원(❌) 상태이므로, 애플 실리콘이나 ARM 서버에서 임베딩 용도로 바로 쓰려면 지원 여부를 먼저 확인해야 합니다.
토리스의 판단
- CPU 전용 로컬 AI·RAG 백엔드를 구축할 때: VRAM이 부족한 맥북이나 저가형 x86 CPU 서버에서 임베딩(
BitNet-embedding-0.6B)과 경량 추론(BitNet-b1.58-2B-4T) 비용을 0원에 가깝게 낮추고 싶다면 바로 테스트해 볼 가치가 있습니다. - 최고 수준의 한국어 추론·복잡한 코딩 품질이 필요할 때: 2.4B급 삼진 모델만으로 클라우드 플래그십 모델을 대체하기는 어렵습니다. 이 경우 범용 어시스턴트는 API로 두고, 오프라인·사내망·고빈도 전처리나 음성 인식(
VibeASR.cpp) 같은 구간에만bitnet.cpp를 배치하는 하이브리드 구성을 권장합니다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾