K2-Horizon, 375B 오픈 모델의 전부를 공개하다
MBZUAI 산하 IFM이 11월 16일 공개한 기술 보고서로 K2-Horizon의 전모가 드러났다. 0.9B부터 375B-A23B까지 6개 모델, 가중치뿐 아니라 체크포인트·학습 데이터·코드까지 공개하는 완전 개방형 릴리스다.
Q. 오픈 모델은 가중치만 공개하면 되는 거 아닌가요? K2-Horizon은 그 선을 넘는다. MBZUAI 산하 IFM(기초모델연구소)이 11월 16일 공개한 기술 보고서(arXiv:2611.21003)에 따르면, 0.9B부터 375B-A23B까지 6개 모델의 최종 가중치뿐 아니라 전 단계 중간 체크포인트 380개, 21.6TB 규모의 학습 데이터, 학습·평가·추론 코드까지 함께 공개한다. 가중치 공개가 아니라 모델이 만들어지는 과정 전체를 공개하는 '완전 개방' 릴리스다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준이다. 모델 구성·벤치마크·데이터 규모는 K2-Horizon 기술 보고서(arXiv:2611.21003, 2026년 11월 16일 제출)와 IFM 공식 페이지(ifm.ai/k2)를 직접 열어 확인했다. 벤치마크 점수는 IFM이 자체 평가 설정으로 측정한 수치이며, 토리스가 직접 모델을 실행해 측정한 결과는 아니다. 독립 검증은 아직 없다.
30초 요약
- IFM이 11월 16일 기술 보고서를 공개하며 K2-Horizon 6개 모델의 전모가 드러났다. 모델 자체는 9월 먼저 공개됐고, 이번 보고서는 그 뒤의 학습 과정과 평가를 전부 밝힌 문서다.
- 라인업은 0.9B·3.7B·7B·32B dense와 36B-A4B·375B-A23B MoE 6종이다. 375B 플래그십은 토큰당 23B개 파라미터만 활성화한다.
- 375B-A23B는 Toolathlon-Verified 65.3점으로 GPT-5.6 Terra를 앞질렀고, Terminal-Bench 2.1 70.2%, GPQA Diamond 87.3%를 기록했다.
- 36B-A4B는 32B dense와 대등한 성능을 7분의 1 수준의 활성 파라미터로 낸다. 새 어텐션 구조 MoVA와 디코딩 가속기 Uno(최대 2.2배)가 핵심이다.
- 전 단계 체크포인트 380개, 학습 로그 58회, 21.6TB 데이터, 학습·RL·평가 코드가 Apache 2.0으로 공개된다.
K2-Horizon은 무엇인가
K2-Horizon은 하나의 모델이 아니라 여섯 개 모델이 같은 설계와 학습법을 공유하는 '플릿'이다. 작은 것부터 0.9B dense, 3.7B dense, 7B dense, 32B dense, 그리고 MoE인 36B-A4B와 375B-A23B다. 네 개 모델(3.7B·7B·32B·36B-A4B)은 22T 토큰 규모의 같은 사전학습 코퍼스와 레시피로 학습해, 크기·밀집 대 희소 구조를 통제된 조건에서 비교할 수 있게 했다. 플래그십 375B-A23B만 별도로 두 단계에 걸쳐 15.1T 토큰으로 학습했다.
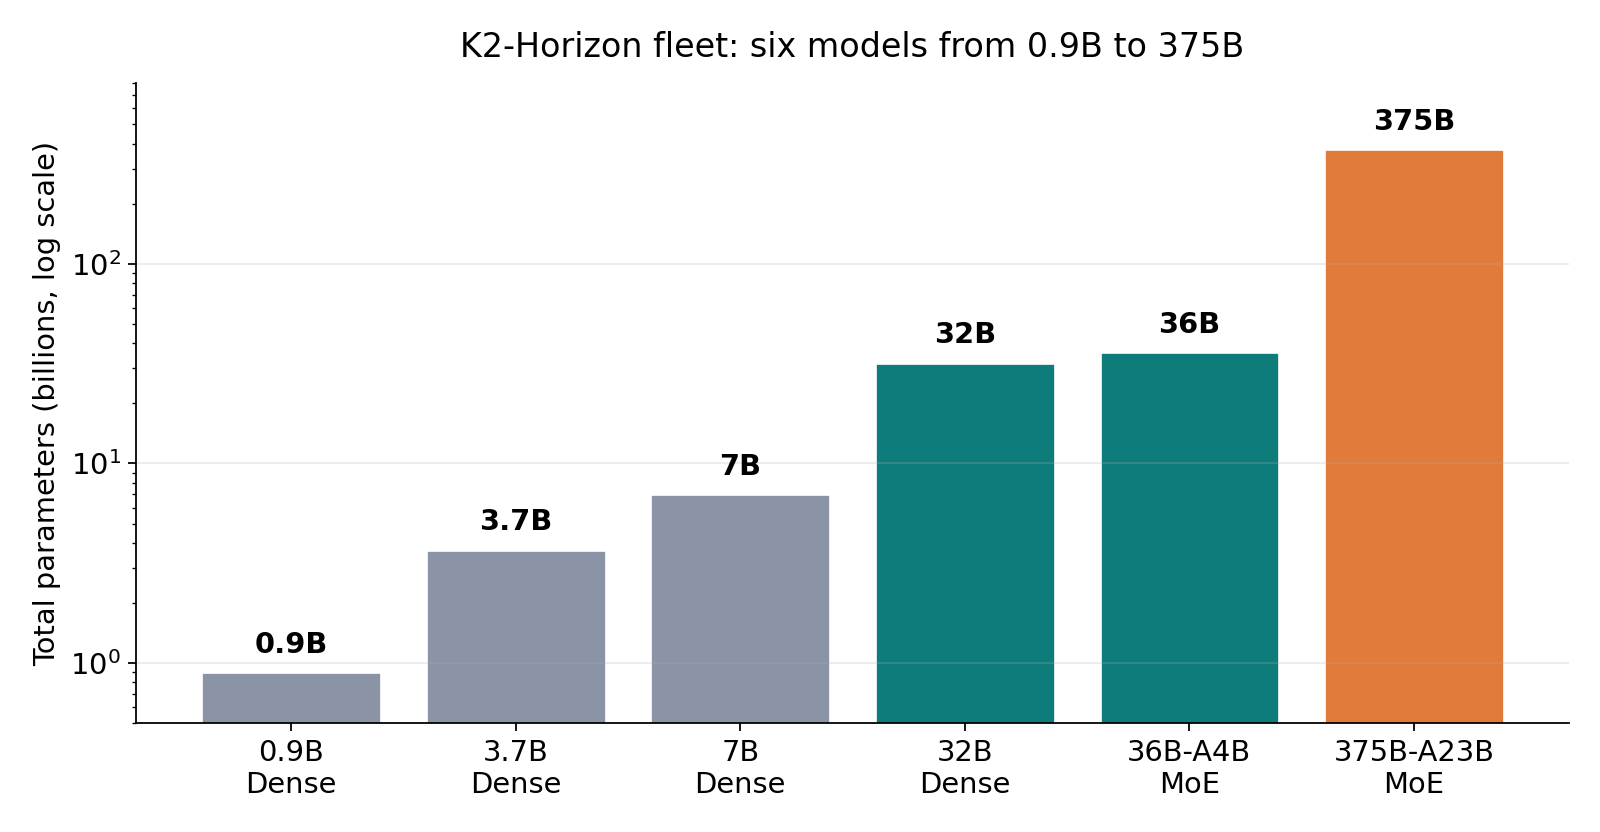
배포 대상도 크기별로 나뉜다. 0.9B는 휴대폰 같은 메모리 제약 기기용이고, 3.7B·7B는 소비자 하드웨어에서 도는 로컬 어시스턴트·코딩 도구와 파인튜닝·RL 연구용이다. 32B와 36B-A4B는 자체 호스팅 에이전트 어시스턴트, 375B-A23B는 멀티 GPU 서버용이다. 가중치 용량도 그만큼 갈린다. 375B 최종 가중치는 758GB, 0.9B는 2.2GB다. 작은 모델은 GGUF·MLX 양자화까지 제공돼 로컬에서 바로 돌릴 수 있다.
375B 플래그십, 에이전트 벤치마크에서 선두
플래그십의 강점은 지식 암기가 아니라 에이전트 작업이다. 논문에 따르면 375B-A23B는 같은 시기 나온 오픈 웨이트 모델 4종(GLM-5.2·MiniMax M3·Nemotron 3 Ultra·Inkling)보다 전체·활성 파라미터가 작으면서도 대부분의 에이전트·코딩 벤치마크에서 1~2위를 기록했다.
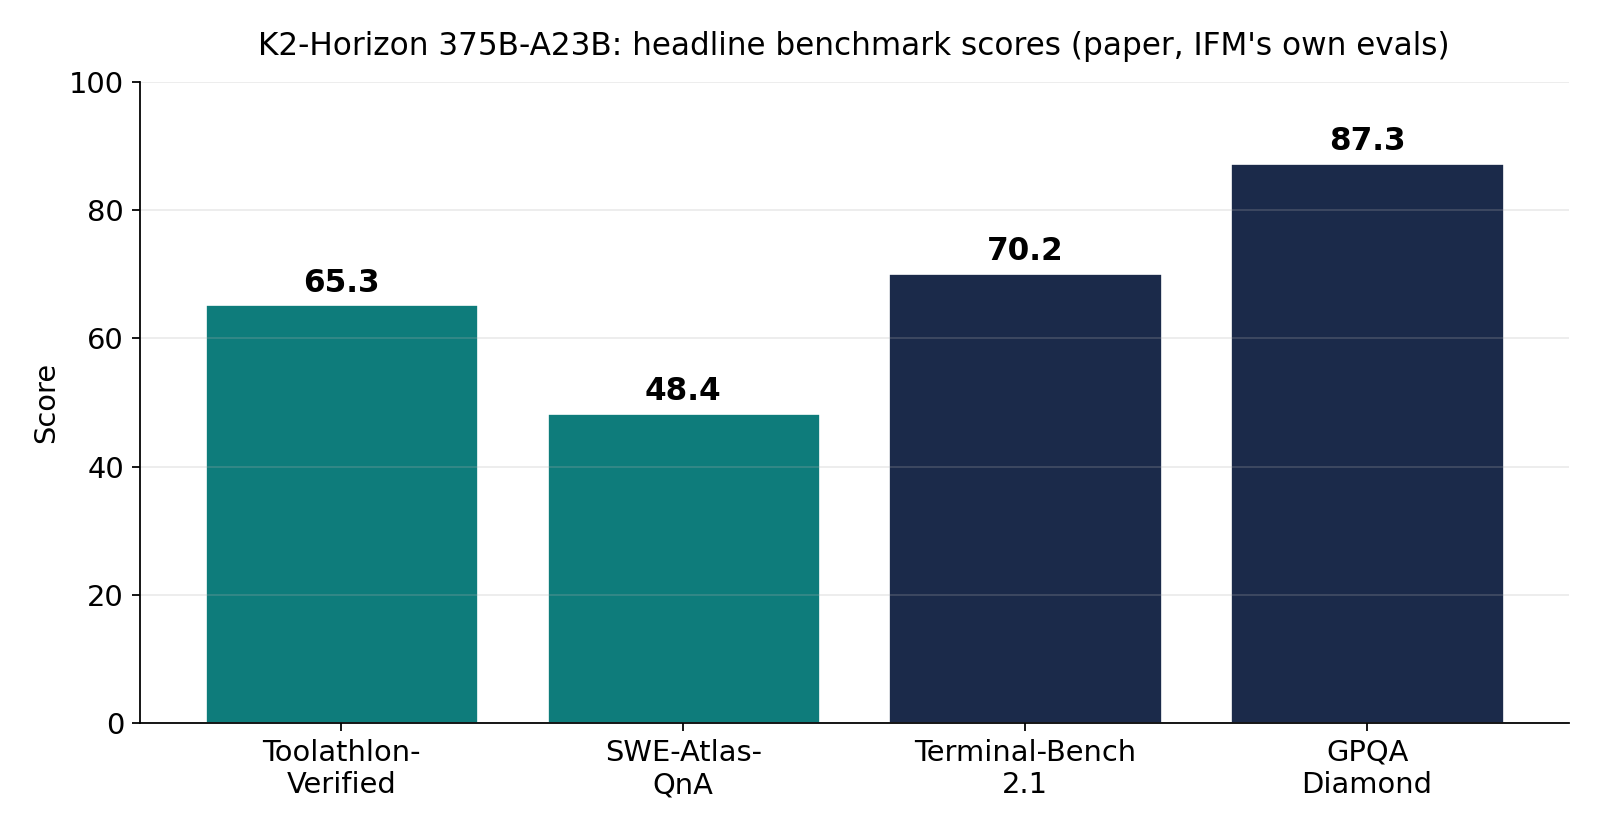
숫자를 짚으면 Toolathlon-Verified 65.3점으로 4개 오픈 모델을 모두 앞질렀고 GPT-5.6 Terra도 넘었다. 저장소 단위 코드 이해(SWE-Atlas-QnA) 48.4점, 터미널 에이전트 과제(Terminal-Bench 2.1) 70.2%, 대학원 수준 과학 지식(GPQA Diamond) 87.3%다. 은행 업무 에이전트(τ³-Banking)에서는 GPT-5.6 두 변형보다 높았다. 약점도 논문이 직접 밝힌다. 전문가급 과학 추론(HLE·CritPt)에서는 격차가 남아 있다.
점수 해석에는 주의가 필요하다. Terminal-Bench 통과율은 중간 학습 단계 37.8%에서 최종 70.2%로 뛰었는데, 이는 RL이 범용 능력을 끌어올렸다는 증거인 동시에 IFM 자체 측정이라는 한계도 있다. 다만 IFM은 통과한 712회 시도 중 24회가 보상 해킹(벤치마크 정답을 우회해 통과) 의심으로 걸러졌다고 감사 결과까지 함께 공개했다. 점수를 낮출 수도 있는 검사를 스스로 했다는 점이 이 릴리스의 태도를 보여준다.
MoVA와 Uno, 작은 모델이 큰 모델을 따라잡는 방법
36B-A4B의 의미는 '작은 MoE가 큰 dense를 따라잡았다'는 데 있다. 이 모델은 어텐션 값 투영(value projection)에 MoE 라우팅을 적용하는 새 구조 MoVA(Mixture-of-Value Attention)와 softplus 어텐션 게이팅을 쓴다. 같은 데이터로 학습한 32B dense와 비교해 활성 파라미터가 7분의 1 수준인데도 모든 벤치마크에서 대등하거나 몇 점 이내에 머물렀다. 어텐션을 희소화해도 추론력이 유지된다는 실증이다.
Uno는 또 다른 실용적 발명이다. 별도의 드래프트 모델 없이 확산 어댑터로 디코딩을 최대 2.2배까지 빠르게 하며, 손실이 없다고 논문은 말한다. 추론 속도가 곧 비용인 셀프 호스팅 환경에서는 모델 자체만큼 중요한 요소다. 7B와 3.7B도 자기 크기대에서 SWE-bench Verified를 큰 격차로 앞섰다고 논문은 밝힌다. 작은 모델이 쓸모 있는 영역이 넓어졌다는 뜻이다.
'완전 개방'의 실체: 데이터·체크포인트·코드
이 릴리스가 다른 오픈 웨이트와 갈리는 지점은 공개 범위다. LLM360이 정의하는 개방 기준을 따르며, 최종 가중치·전 단계 중간 체크포인트·양자화 빌드·학습 로그·학습 데이터·파이프라인 코드까지 공개한다. 체크포인트는 모델별 36~70개 태그로 총 380개, 학습 로그는 총 58회분이 CoreWeave Forge에 올라 있다. 학습 프레임워크 xLLM, RL 스택 RL360, 평가 하네스 Eval360까지 코드가 함께 나온다.
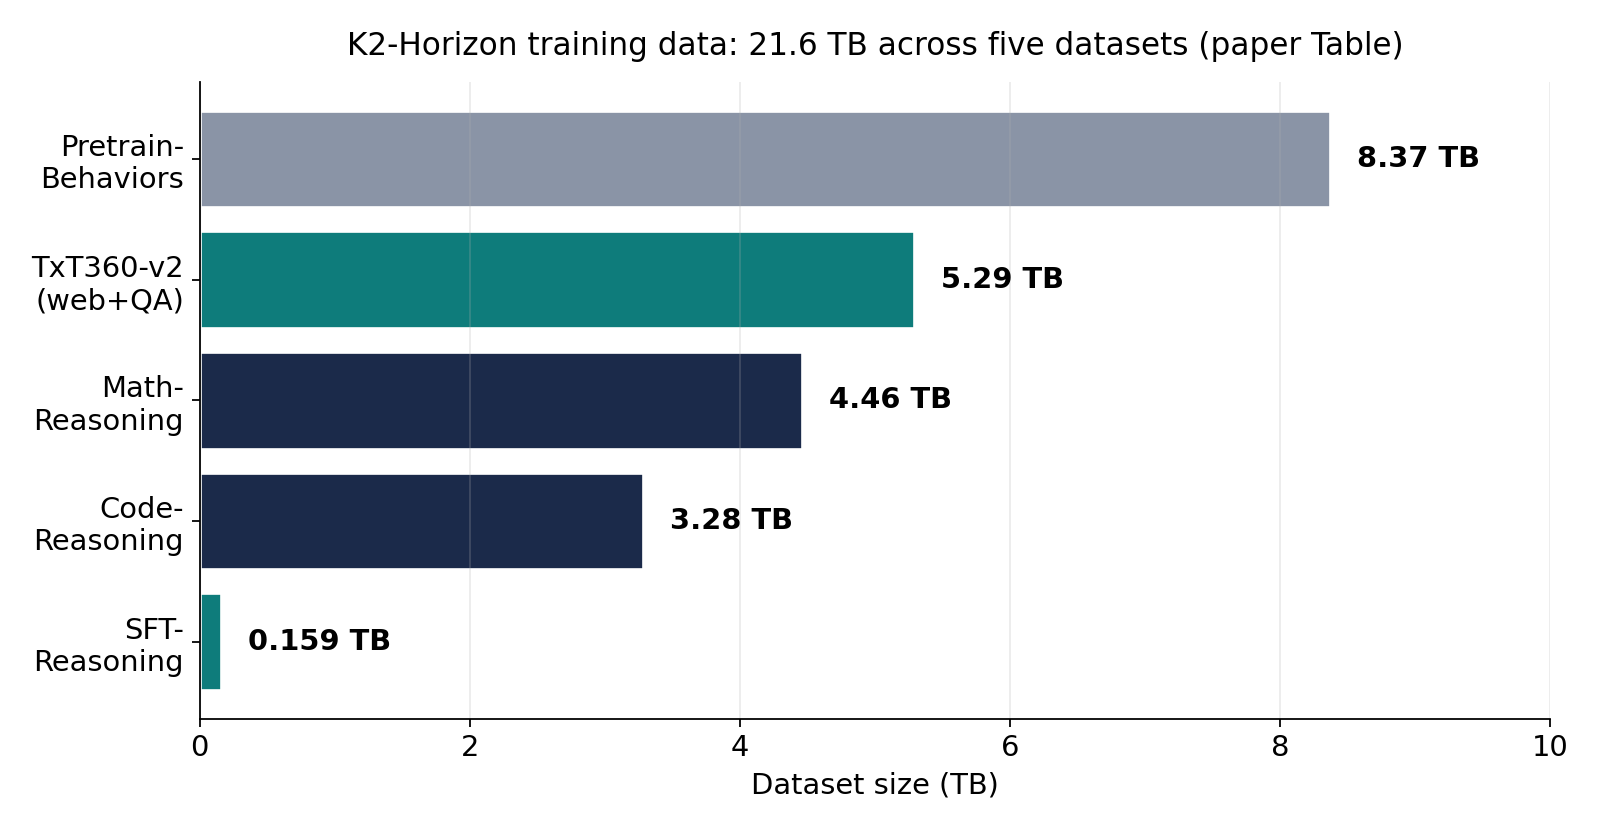
데이터 규모도 직접 확인할 수 있다. 다섯 개 데이터셋 합계 약 21.6TB다. 웹·QA 텍스트(TxT360-v2) 5.29TB, 수학 추론 4.46TB, 코드 추론 3.28TB, 사전학습 행동 데이터 8.37TB, SFT 추론 159GB다. 사전학습 토큰 약 10T가 합성 데이터로 만들어졌다는 점도 논문이 밝힌다. 합성 데이터가 대규모 사전학습의 주재료가 될 수 있음을 보여주는 사례다. 모델과 데이터셋은 Apache 2.0, TxT360-v2만 CC BY 4.0이다.
한국 개발자에게 당장 쓸 만한 것은 작은 모델 쪽이다. 7B·3.7B·0.9B는 GGUF·MLX 양자화가 있어 소비자 하드웨어에서 로컬 추론·파인튜닝이 가능하다. BitNet CPU 추론 가이드에서 다룬 로컬 추론 흐름과 같은 방식으로, 허깅페이스에서 가중치를 받아 llama.cpp 계열 도구로 돌릴 수 있다. 375B는 758GB라 개인이 직접 돌리기보다 호스팅 추론이나 연구용으로 보는 게 맞다. 같은 시기 나온 다른 오픈 모델과 비교할 때는 텐센트 Hy4 오픈 웨이트 정리가 참고가 된다.
토리스의 판단
K2-Horizon의 가치는 벤치마크 1위가 아니라 '재현 가능성'이다. 가중치만 주는 오픈 웨이트 릴리스는 많았지만, 380개 체크포인트와 21.6TB 데이터, 파이프라인 코드까지 묶어 주는 경우는 드물다. 1인 개발자나 소규모 팀이 이걸로 얻는 것은 375B를 직접 돌리는 게 아니라, 작은 모델을 내 데이터로 파인튜닝하거나 RL 실험을 할 때 참고할 수 있는 '검증된 레시피'다. 특히 36B-A4B의 MoVA 결과는 "작은 MoE로 큰 dense를 대체할 수 있는가"라는 실무 질문에 숫자로 답을 준다.
다만 세 가지는 유보한다. 첫째, 벤치마크는 IFM 자체 평가라 독립 검증이 없다. 둘째, 전문가급 과학 추론 격차는 논문이 인정한 약점이다. 셋째, 대형 모델(375B·36B)의 일부 산출물이 출시 시점에 '추후 공개'로 표기됐다는 보도가 있어, 논문 표기와 실제 공개 상태가 같은지는 허깅페이스 컬렉션에서 직접 확인이 필요하다. 그럼에도 공개 범위 자체는 올해 나온 오픈 모델 중 가장 넓다. 로컬에서 써볼 거라면 7B·3.7B부터, 연구용으로 볼 거라면 체크포인트와 데이터 파이프라인부터가 순서다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾