MarkItDown(microsoft/markitdown) — PDF·오피스 문서를 LLM용 마크다운·MCP로 바꾸는 법
Microsoft 오픈소스 MarkItDown의 지원 포맷, 선택형 설치, markitdown-ocr, markitdown-mcp 서버 연동 및 보안 가이드를 정리합니다.
Q. PDF·PPT·엑셀 문서를 AI 에이전트에 넣기 전에 왜 굳이 마크다운으로 바꿔야 하나요? GPT-4o를 비롯한 주요 LLM은 마크다운 문법을 훈련 데이터에서 방대하게 학습해 제목·목록·표 구조를 정확히 읽습니다. 마이크로소프트의 오픈소스
MarkItDown은 PDF와 오피스 문서를 토큰 효율이 높은 마크다운으로 한 번에 정리해 RAG와 에이전트 파이프라인에 바로 넣을 수 있게 해 줍니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준
microsoft/markitdown공식 GitHub 저장소(API·README)와v0.1.9릴리즈 노트(2026-10-21 발행)를 직접 확인해 작성했습니다. GitHub 별·포크 수와 지원 옵션은 이후 업데이트로 바뀔 수 있으며, Azure Document Intelligence·Content Understanding 및 이미지 캡셔닝·음성 전사 비용은 별도 과금 정책을 확인해야 합니다.
30초 요약
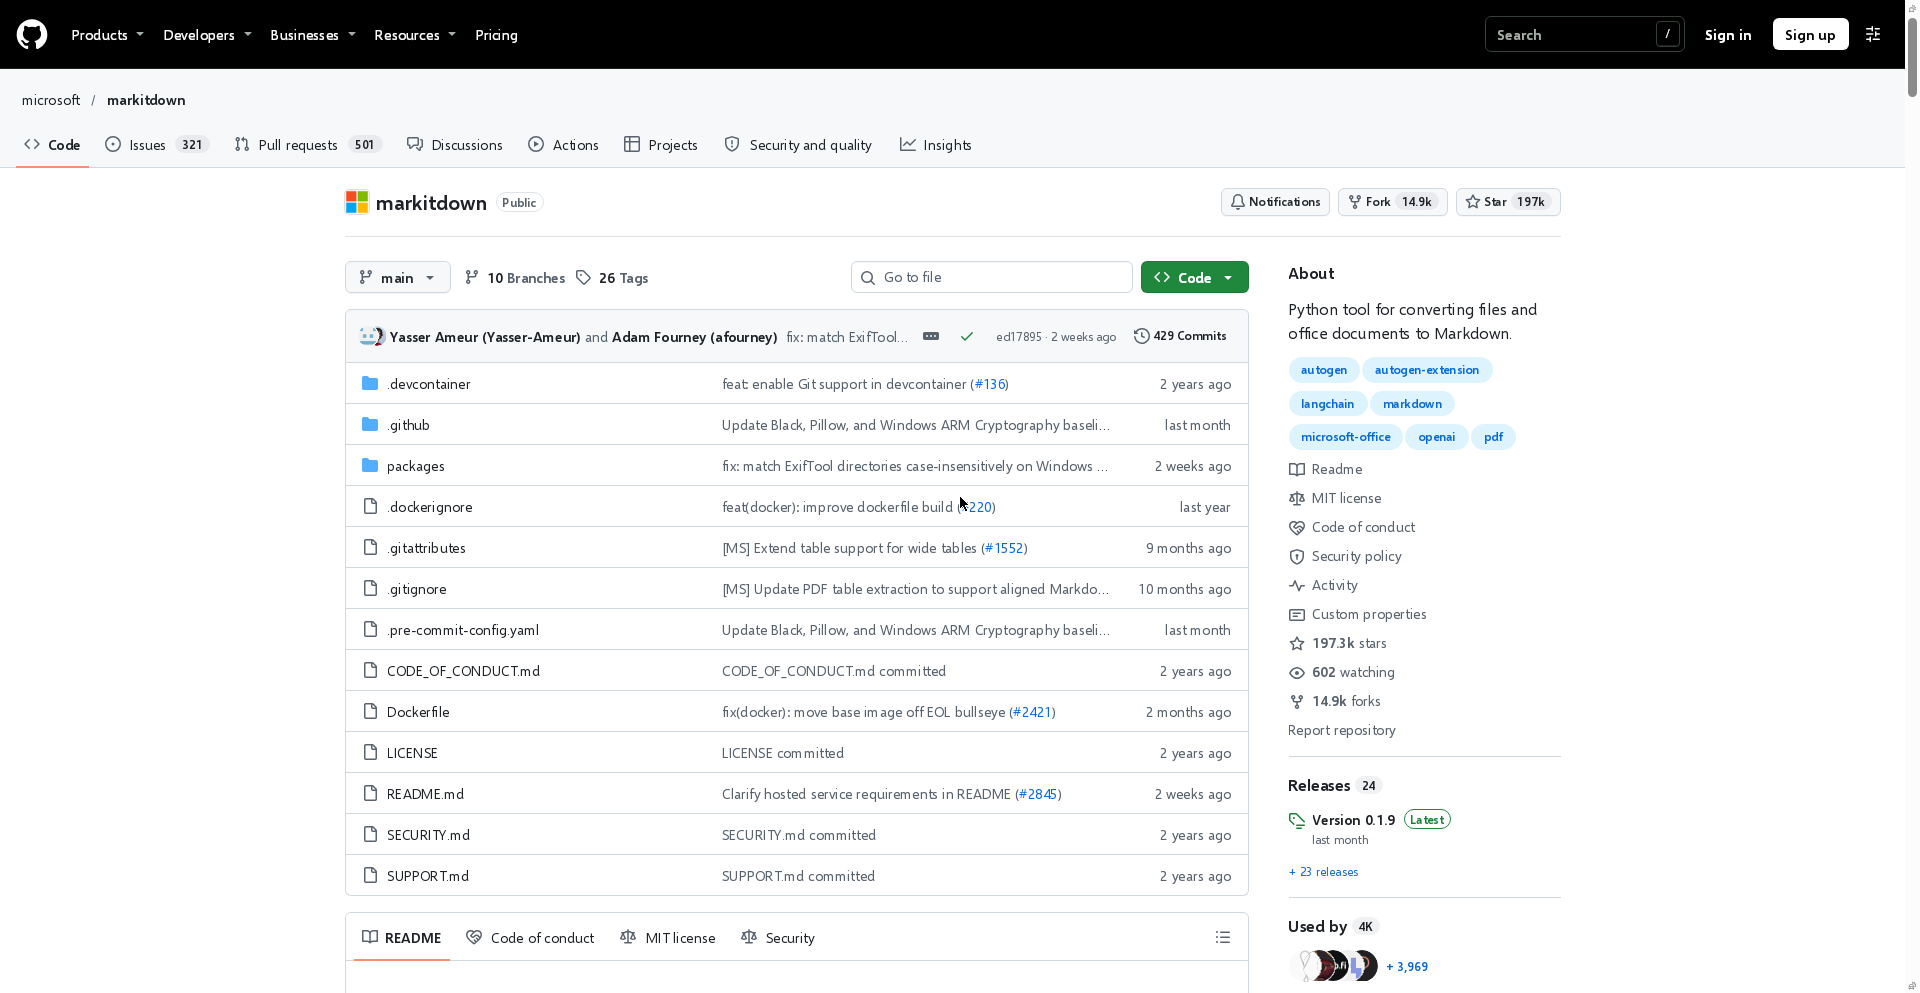
- 압도적 생태계: Microsoft가 공개한 MIT 라이선스 Python 도구로, 2026년 11월 21일 기준 GitHub 별 197,251개, 포크 14,935개, 최신 버전
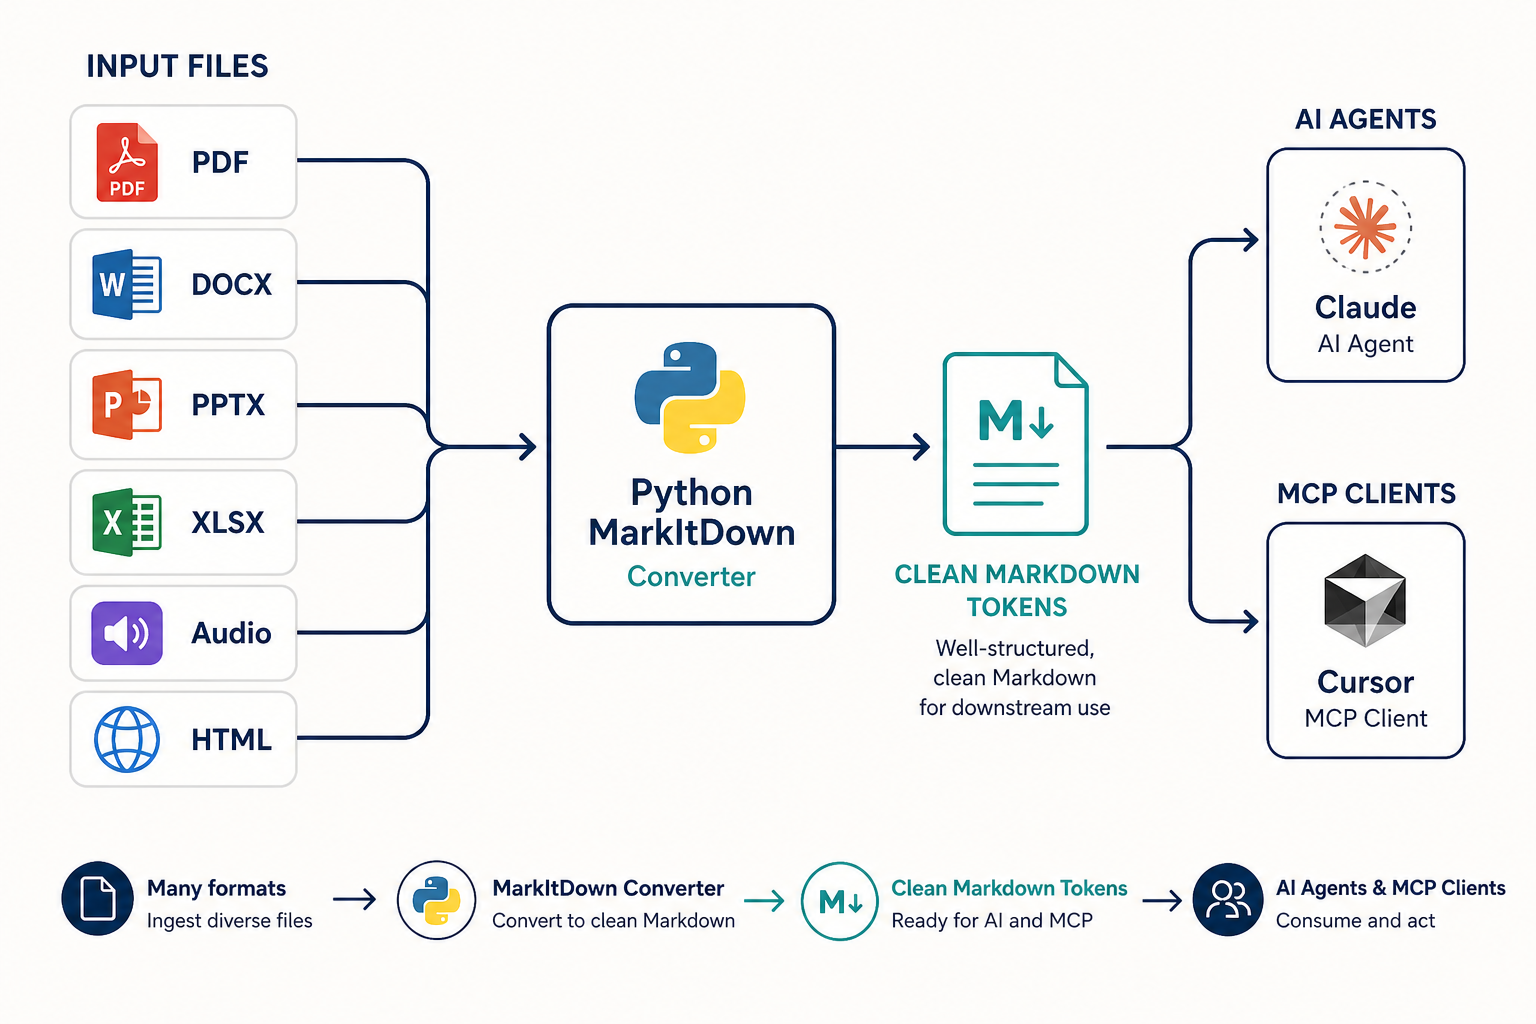
v0.1.9를 기록 중입니다. - 폭넓은 포맷 지원: PDF·PowerPoint·Word·Excel·HTML·CSV·JSON·XML·ZIP·EPub은 물론 이미지 EXIF·캡셔닝, 오디오 전사, YouTube 자막 URL까지 처리합니다.
- 가벼운 로컬 기본기: 기본 변환기는 로컬 연산만 사용하며, 필요할 때만
[pdf, docx, pptx]처럼 원하는 의존성만 골라 설치할 수 있습니다. - MCP와 OCR 확장:
markitdown-mcp패키지로 Claude Desktop이나 Cursor에convert_to_markdown(uri)도구를 붙이고,markitdown-ocr플러그인으로 이미지 속 텍스트도 뽑아냅니다.
왜 plain text 대신 MarkItDown인가
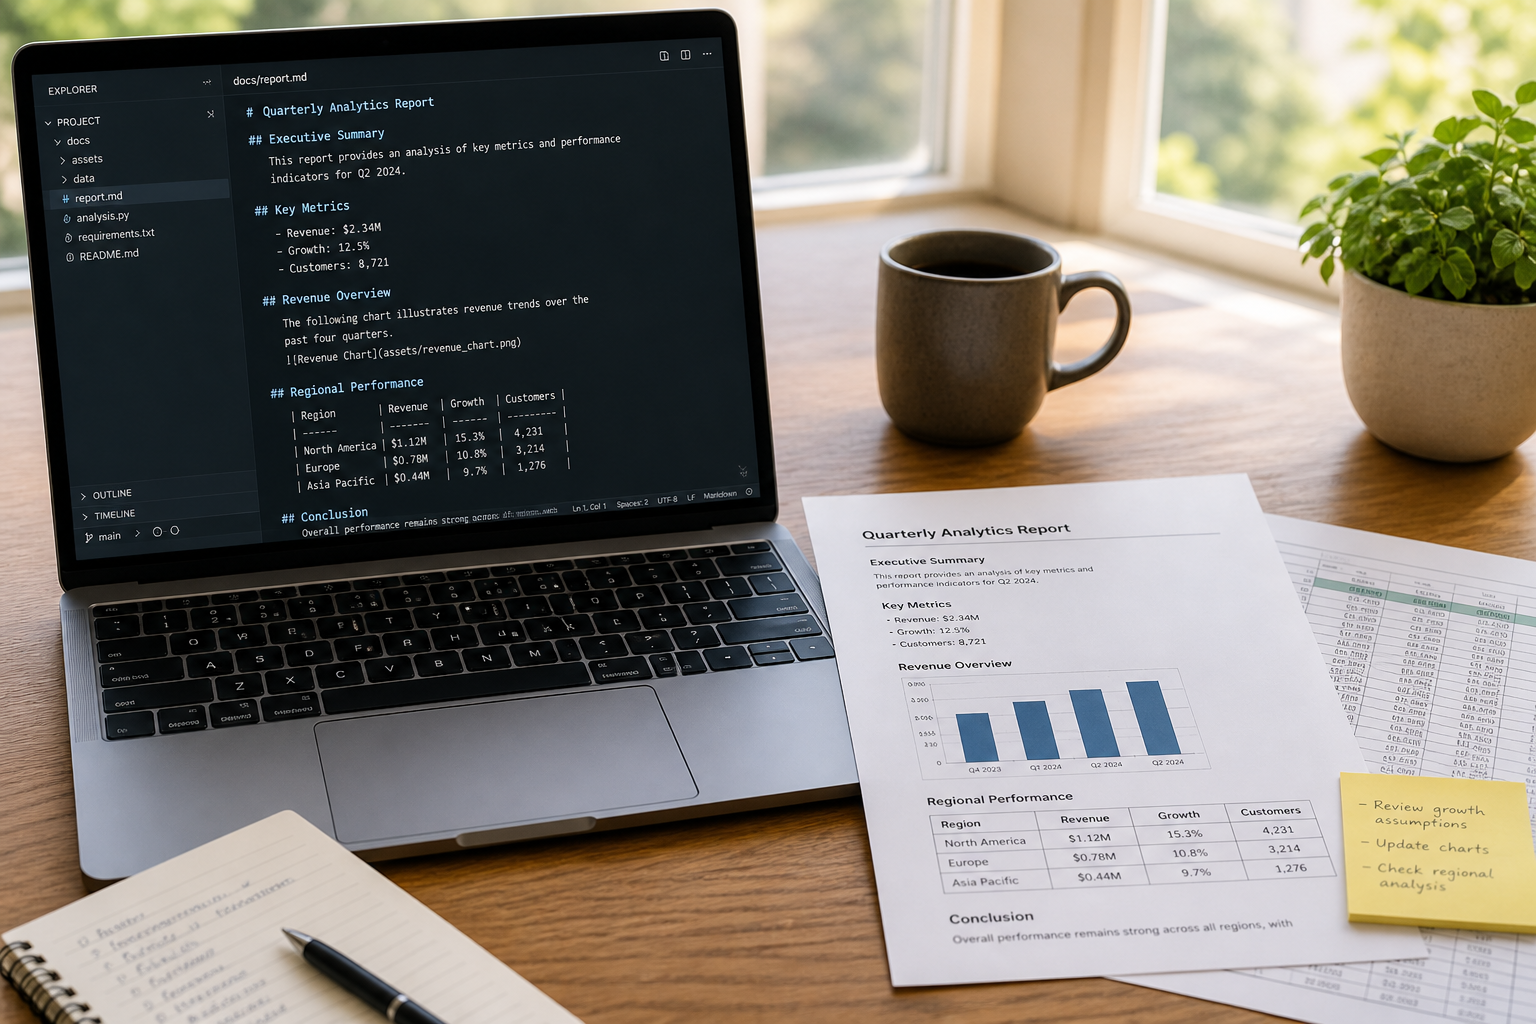
LLM 파이프라인에서 문서를 뽑을 때 가장 아까운 것은 깨진 표와 사라진 제목 위계입니다. 기존 textract 계열 도구가 글자만 줄줄이 긁어내는 데 집중했다면, MarkItDown은 제목(#), 목록(-), 표(|), 링크([text](url)) 같은 문서 골격을 최대한 살려 냅니다.
사람이 그대로 인쇄해 읽는 고해상도 레이아웃 복원이 목적은 아닙니다. 대신 AI 모델이 문맥을 오해하지 않고 적은 토큰으로 핵심을 파악하도록 최적화되어 있습니다. 웹 페이지를 AI용 마크다운으로 긁어오는 작업이 Firecrawl & Firecrawl Local의 영역이라면, 이미 내 컴퓨터와 사내 드라이브에 쌓여 있는 PDF·PPT·엑셀 문서를 정리하는 역할은 MarkItDown이 맡는 셈입니다.
설치와 선택형 의존성 구조
Python 3.10 이상 3.14 이하 환경이라면 가상환경을 만든 뒤 한 줄로 설치할 수 있습니다. 전체 포맷을 다 쓰고 싶다면 [all] 옵션을, 서버 용량을 줄이고 싶다면 필요한 포맷 키만 괄호 안에 적으면 됩니다.
python -m venv .venv
source .venv/bin/activate
pip install 'markitdown[all]'
실무에서 자주 쓰는 선택형 의존성 키는 다음과 같습니다.
| 의존성 옵션 | 활성화되는 기능 | 비고 |
|---|---|---|
[all] |
전체 선택 포맷 일괄 설치 | 로컬 테스트·개발용 |
[pdf, docx, pptx] |
PDF, Word, PowerPoint | 문서 RAG 핵심 조합 |
[xlsx, xls] |
최신 및 구형 Excel 시트 | 표 데이터 추출 |
[outlook] |
Outlook .msg 메일 파일 |
사내 아카이브 분석 |
[audio-transcription] |
.wav, .mp3 음성 전사 |
외부 호스트 서비스 연동 |
[youtube-transcription] |
YouTube 영상 자막 추출 | URL 직접 입력 지원 |
[az-doc-intel] / [az-content-understanding] |
Azure 클라우드 레이아웃·멀티모달 분석 | 유료 Azure API 호출 |
CLI 사용법도 단순합니다. 터미널에서 리다이렉션(>)이나 -o 플래그, 혹은 파이프(|)로 바로 연결됩니다.
markitdown report.pdf -o report.md
cat report.pdf | markitdown
Python API, OCR 플러그인, Azure 확장
코드 안에서 문서를 다룰 때는 MarkItDown().convert() 호출 두 줄로 끝납니다. 여기에 이미지나 발표자료 설명이 필요하면 OpenAI() 같은 llm_client와 llm_model을 넘겨 비전 모델이 슬라이드와 사진 내용을 서술하게 할 수 있습니다.
from markitdown import MarkItDown

md = MarkItDown(enable_plugins=False)
result = md.convert("quarterly_plan.xlsx")
print(result.markdown)
스캔된 PDF나 이미지가 많이 섞인 문서라면 서드파티 플러그인 markitdown-ocr이 유용합니다. MarkItDown은 기본 상태에서 보안상 플러그인을 꺼 두므로(--use-plugins 또는 enable_plugins=True), 명시적으로 켜고 llm_client를 함께 넘겨야 이미지 속 텍스트 OCR이 동작합니다.
로컬 파싱으로 한계가 있는 복잡한 다단 표, 스캔 문서, 혹은 **오디오·비디오 파일의 구조화 필드 추출(YAML front matter)**이 필요하다면 Azure 연동을 선택할 수 있습니다. 아래는 공식 문서 기준 세 가지 변환 모드의 차이입니다.
| 구분 | 기본 내장 변환기 | Azure Document Intelligence | Azure Content Understanding |
|---|---|---|---|
| 문서 변환 방식 | 오프라인 포맷별 파싱 | 클라우드 레이아웃 분석 | 클라우드 멀티모달 분석 |
| 구조화 필드 추출 | 미지원 | 모델·쿼리 필드 기반 YAML | 분석기 필드 기반 YAML |
| 오디오·비디오 | 기본 오디오만 지원 | 미지원 | 오디오·비디오 모두 지원 |
| 비용 | 로컬 연산(무료) | Azure API 종량 과금 | Azure API 종량 과금 |
MCP 서버(markitdown-mcp)로 Claude·Cursor에 붙이기
에이전트가 내 파일이나 웹 문서를 직접 마크다운으로 읽어 오게 하려면 markitdown-mcp 패키지를 씁니다. 이 패키지는 STDIO, Streamable HTTP, SSE 세 가지 전송 방식을 지원하며, MCP 클라이언트에 convert_to_markdown(uri) 도구 하나를 노출합니다. URI는 http:, https:, file:, data:를 모두 받습니다.
pip install markitdown-mcp
# STDIO 기본 실행
markitdown-mcp
# Streamable HTTP / SSE 로컬 실행
markitdown-mcp --http --host 127.0.0.1 --port 3001
Claude Desktop에서는 로컬 파일 접근 권한을 격리하기 위해 Docker 컨테이너에 특정 폴더만 마운트(/workdir)해 연결하는 방식이 공식 권장됩니다.
{
  "mcpServers": {
    "markitdown": {
      "command": "docker",
      "args": [
        "run", "--rm", "-i",
        "-v", "/home/user/data:/workdir",
        "markitdown-mcp:latest"
      ]
    }
  }
}
보안 주의사항: 편한 만큼 권한 경계를 좁혀야 합니다
Q.
convert()함수나markitdown-mcp를 그대로 사내 웹 서비스에 올려도 될까요? 절대 권장하지 않습니다. MarkItDown은 현재 프로세스 권한 그대로 파일 I/O와 네트워크 요청을 실행하며,markitdown-mcp자체에는 인증 기능이 없습니다.
공식 보안 가이드라인은 가장 좁은 범위의 API를 쓰라고 명확히 적고 있습니다. 로컬 파일만 읽는 서버라면 범용 convert() 대신 convert_local()을 쓰고, 외부 URL을 다룰 때는 애플리케이션이 직접 URL 검증(사설 IP, 루프백, 링크-로컬, 클라우드 메타데이터 주소 차단)을 거친 뒤 convert_response()나 convert_stream()에 스트림만 넘겨야 합니다. 또한 이미지 캡셔닝과 음성 전사는 외부 웹 서비스를 호출하므로 완전한 오프라인 폐쇄망이 필요하다면 관련 선택 의존성을 빼고 설치해야 합니다.
토리스의 판단
웹 크롤링보다 사내 오피스 문서·PDF 정리가 급한 1인 개발자나 팀이라면 오늘 바로 도입할 가치가 있습니다. 특히 Claude Desktop이나 Cursor에서 매번 PDF를 통째로 붙여넣다 토큰 한도에 걸렸던 경험이 있다면 markitdown-mcp를 Docker로 띄워 두는 것만으로도 작업 속도가 크게 달라집니다.
반대로 웹페이지 렌더링(SPA 자바스크립트 실행)이나 사이트 전체 맵핑이 목적이라면 MarkItDown보다 Firecrawl Local 쪽이 훨씬 정확합니다. 두 도구를 역할별로 나누어 쓰면 웹과 로컬 문서를 모두 깔끔한 마크다운으로 통합할 수 있습니다. 토리스 스튜디오의 자동화·개발 문의는 서비스 안내에서 확인하실 수 있습니다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾